쿠버네티스 v1.37: Garhwal
편집자: Arsh Sharma, Christopher Tineo, Kirti Goyal, Sophia Ugochukwu, Swathi Rao, Troy Connor
이전 릴리스와 마찬가지로 쿠버네티스 v1.37 릴리스에는 새로운 스테이블(Stable), 베타(Beta), 알파(Alpha) 기능이 포함되었습니다. 고품질 릴리스를 꾸준히 제공할 수 있는 것은 쿠버네티스 개발 주기의 강력함과 활발한 커뮤니티 덕분입니다.
이번 릴리스에는 67개의 개선 사항이 있습니다. 그중 16개는 스테이블로, 23개는 베타로 승격되었고, 27개는 알파 단계에 진입했으며, 1개는 사용 중단/제거되었습니다.
릴리스 테마와 로고
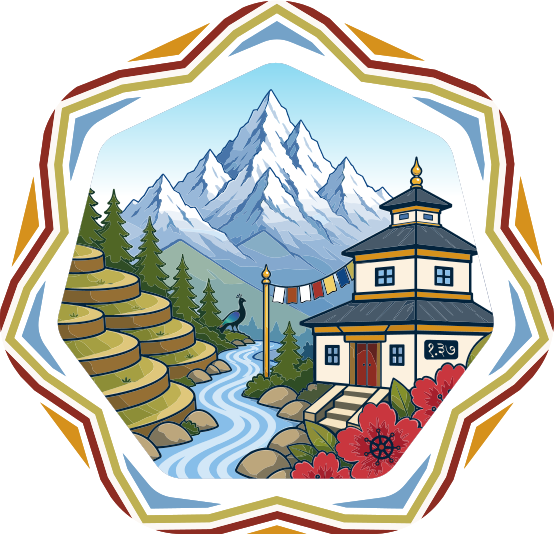
쿠버네티스 v1.37의 테마는 인도 우타라칸드주의 히말라야 지역인 가르왈(Garhwal)(गढ़वाल, gaṛhvāl로 발음)입니다. 가르왈 히말라야의 눈 덮인 봉우리, 데오다르 삼나무 숲, 계단식 논밭, 강과 시내, 그리고 산길이 이 지역과 로고를 함께 빚어냅니다. 이 요소들이 어우러져 모든 층위와 경로와 기여가 서로 이어져 있는 공동체를 담고 있습니다.
이 로고는 가르왈의 풍경을 들여다보는 창으로 그려졌습니다.1 창 안에서는 계단식 논밭이 눈 덮인 봉우리를 향해 올라가고, 각 단은 그 아래 단이 떠받치고 있습니다. 모든 쿠버네티스 릴리스가 앞서 이어져 온 작업에 기대고 있는 것과 같습니다. 강은 골짜기를 굽이쳐 흐르며 산의 시내들을 모아들이는데, 여러 SIG와 커뮤니티의 기여가 하나의 프로젝트로 흘러드는 모습을 담고 있습니다.
데오다르 삼나무 숲은 서로 다른 프로젝트들이 공통의 기반을 나누며 나란히 자라나는 더 넓은 쿠버네티스 생태계를 나타냅니다. 돌과 나무로 다듬어진 산길과 산속 집은 사람을 한가운데에 두고, 뒤따라올 이들을 위해 지켜온 공동의 토대를 떠올리게 합니다. 강 위로는 색색의 깃발이 바람을 받아 장면에 생기를 불어넣습니다.
장면을 둘러싼 무늬 테두리는 유연한 히말라야 왜성 대나무인 링갈(ringaal) 로 엮은 바구니 세공에서 영감을 받았습니다. 대나무 살 하나하나는 서로 엮일 때 힘을 얻습니다. 코드와 리뷰, 테스트, 문서, 그리고 조율이 한데 모여 하나의 릴리스를 만들어내는 것과 같습니다.
테두리 안의 히말라야 모날은 우타라칸드주를 상징하는 새로, 히말라야 고산 지대에 삽니다. 무지갯빛으로 어른거리는 깃털은 여러 색을 한꺼번에 품고 있는데, 쿠버네티스 커뮤니티가 여러 기술과 관점을 하나의 프로젝트로 모아내는 모습과 닮았습니다. 우타라칸드주를 상징하는 나무인 붉은 buransh(Rhododendron arboreum) 꽃은 가운데에 쿠버네티스 심볼을 품고 있어, 가르왈에서 흔히 보는 꽃과 커뮤니티가 함께 쓰는 심볼을 이어줍니다. 산속 집에는 १.३७(데바나가리 숫자로 1.37)이 새겨져 이번 릴리스를 이 풍경에 뿌리내리게 합니다.
1. 창(로고)을 계속 들여다봅니다. 강이 흐르고 깃발이 바람을 받는 모습을 지켜봅니다. 37초가 지나면 풍경이 마법을 드러냅니다. 😉
주요 업데이트 하이라이트
쿠버네티스 v1.37에는 새로운 기능과 개선 사항이 많습니다. 릴리스 팀이 강조하고 싶은 주요 업데이트 몇 가지를 소개합니다.
스테이블: 견고한 watch 캐시 초기화
쿠버네티스 v1.37은 견고한 watch 캐시 초기화 작업을 마무리합니다.
ResilientWatchCacheInitialization 기능 게이트는 이미 v1.34에서 스테이블이 되었고, v1.37에서는 남아 있던
WatchCacheInitializationPostStartHook 게이트가 스테이블로 승격되어 활성화 상태로 고정됩니다. 이 게이트는 v1.36부터
기본적으로 활성화되어 API 서버가 시작할 때와 복구할 때의 안정성을
높여 왔습니다. 이제 watch 캐시 초기화와 재초기화가 etcd에 대한 요청 트래픽을 급증시키지 않으며,
캐시가 준비되는 동안 요청이 쌓이는 대신 적절히 처리됩니다.
비용이 큰 list와 watch 요청이 etcd에 과부하를 주거나 API 우선순위와 공평성 용량을 소진하도록 두는 대신, kube-apiserver는 이제 제한된 요청만 안전하게 위임하고 나머지는 HTTP 429 응답으로 거부합니다. 이로써 대규모 클러스터에서 컨트롤
플레인 장애가 발생할 위험이 줄어듭니다. 클라이언트(커스텀 컨트롤러와 오퍼레이터 포함)는 Retry-After 헤더를 존중하고 지수 백오프를 구현하여 HTTP 429 Too Many Requests 응답을 무리 없이 처리하도록 설계해야 합니다.
이 작업은 SIG API Machinery가 주도한 KEP #4568의 일환으로 진행되었습니다.
베타: HorizontalPodAutoscaler 0으로 스케일링
쿠버네티스 v1.37에서 HorizontalPodAutoscaler 0으로 스케일링 지원이 베타로 승격됩니다. 쿠버네티스 v1.16에서
처음 도입되었고, 이제 기본적으로 활성화됩니다.
오브젝트(Object) 또는 외부(External) 메트릭을 사용하는 워크로드라면, 이 기능으로 HorizontalPodAutoscaler가 유휴 상태일 때
파드를 0개까지 스케일 다운했다가 수요가 돌아오면 다시 복구할 수 있습니다. 이렇게 하면 큐 컨슈머, 배치 잡,
GPU 워크로드의 비용을 줄일 수 있습니다. spec.minReplicas: 0을 설정하면 워크로드에 이 기능이 적용됩니다.
CPU와 메모리 메트릭을 기준으로 0까지 스케일링하는 것은 활성 상태의 파드에 의존하는 메트릭이라 지원되지 않습니다. 그 대신 이 기능은 처리할 작업이 큐에 쌓일 때까지 레플리카 수를 0으로 두는 것 같은 상황을 위한 것입니다.
HorizontalPodAutoscaler가 워크로드를 0 레플리카로
유지하는 동안에는 HorizontalPodAutoscaler의 상태에 ScaledToZero 컨디션을 True로 기록합니다.
HorizontalPodAutoscaler 컨트롤러는 이 컨디션을 사용해, 자신이 0으로 스케일링한 워크로드(메트릭이 돌아오면
다시 스케일 업할 워크로드)와 레플리카 수를 0으로 설정해 수동으로 비활성화한 워크로드를 구분합니다. 워크로드가
다시 스케일 업되면 컨디션은 NotScaledToZero 사유와 함께 False로 설정됩니다.
이 작업은 SIG Autoscaling이 주도한 KEP #2021의 일환으로 진행되었습니다.
베타: 매니페스트 기반 어드미션 컨트롤 구성
쿠버네티스 v1.37은 매니페스트 기반 어드미션 컨트롤
구성을 베타로 승격합니다. 이제 어드미션 웹훅과 CEL 기반 정책을 쿠버네티스 API 안에만 두지 않고,
AdmissionConfiguration의 staticManifestsDir 필드를 통해 디스크의 매니페스트 파일에서 불러올 수 있습니다. 이렇게 불러온
정책은 API 서버 시작 시점부터 적용되고, etcd를 사용할 수 없는 동안에도 계속 동작하며, API 기반 어드미션
리소스 자체가 변경되지 않도록 보호할 수 있습니다.
이 작업은 SIG API Machinery가 주도한 KEP #5793의 일환으로 진행되었습니다.
알파: 파드 수준 체크포인트와 복원
쿠버네티스 v1.37은 파드 수준 체크포인트와 복원을 알파로 지원하기 시작합니다.
CRI에 CheckpointPod와 RestorePod RPC를 추가해, kubelet 및 호환되는 컨테이너 런타임이 파드 체크포인트를 만들고 그 체크포인트에서 파드를 복원할 수 있게 합니다.
이 기능을 사용하려면 사용 중인 컨테이너 런타임도 이 새 RPC를 구현해야 합니다.
이 작업은 SIG Node가 주도한 KEP #5823의 일환으로 진행되었습니다.
스테이블로 승격된 기능들
스테이블(General Availability라고도 함)로 승격된 모든 기능을 정리했습니다. 신규 기능과 알파에서 베타로 승격된 항목까지 포함한 전체 목록은 릴리스 노트를 참고합니다.
이번 릴리스에는 스테이블로 승격된 개선 사항이 총 16개 포함됩니다.
KYAML
KYAML은 쿠버네티스를 위해 설계된, 더 안전하고 덜 모호한 YAML의 부분집합이며 YAML을 대체하지 않습니다. 모든
KYAML 파일은 유효한 YAML이므로 KYAML은 어떤 버전의 kubectl에도 유효한 입력이고, 입력을 파싱하기 위해 스펙 파일을
KYAML로 작성할 필요는 없습니다. 기존 매니페스트와 도구, 파이프라인을 바꿀 필요가 없습니다.
v1.34에서 알파 기능으로 도입되어 v1.35에서 베타로 승격된 KYAML은 적합성 테스트를 마치고 v1.37에서 스테이블로
승격되며, kubectl get -o kyaml도 이제 스테이블입니다.
KYAML에 대해 더 알아보려면 쿠버네티스 YAML을 KYAML로 보기 좋게 출력하는 방법과 그 이유를 확인합니다.
이 작업은 SIG CLI가 주도한 KEP #5295의 일환으로 진행되었습니다.
metrics.k8s.io API
metrics.k8s.io API가 베타에 9년 가까이 머문 끝에 쿠버네티스 v1.37에서 스테이블로 승격됩니다. 이 API는 파드와
노드의 CPU, 메모리 사용량을 조회하는 표준 방법을 제공하며, HorizontalPodAutoscaler(HPA) 같은 널리 쓰이는
쿠버네티스 기능과 kubectl top 같은 명령을 뒷받침합니다.
이번 승격은 영구 베타 API를 두지 않겠다는 쿠버네티스 프로젝트의 목표를 따른 것입니다. 이제 v1이 생겼으므로
앞으로의 쿠버네티스 릴리스는 v1으로 전환될 예정입니다. v1beta1은 API 사용 중단 정책에 따라 전환 기간 내내
계속 쓸 수 있으므로, 기존 워크플로우를 깨뜨리지 않고 스테이블 API를 도입할 수 있습니다.
이 작업은 SIG Instrumentation이 주도한 KEP #5207의 일환으로 진행되었습니다.
SELinuxMount와 SELinuxChangePolicy
쿠버네티스 v1.37에서 SELinuxMount와 SELinuxChangePolicy 플래그가 스테이블에 도달하고 기본적으로 활성화됩니다. 즉,
볼륨이 재귀적으로 다시 레이블링되는 대신 -o context=<label>(MountOption 기본값)로 마운트되지만, 이는 해당 볼륨의
CSI 드라이버가 CSIDriver 오브젝트에 .spec.seLinuxMount: true로 선언한 경우에만 그렇습니다.
마운트 하나는 SELinux 컨텍스트를 하나만 가질 수 있습니다. 그래서 같은 노드에서 볼륨을 공유하면서 SELinux 레이블이
서로 다른 파드들은, 재귀적 재레이블링에서는 공존했지만 이제 시작에 실패할 수 있습니다.
워크로드에서 기존 동작을 유지하려면 파드에 .spec.seLinuxChangePolicy를 Recursive로 설정하기를 권장합니다.
이 동작 자체도 v1.38이 되어야 고정되므로, 클러스터 전역에서 비활성화하는 선택지는 한 릴리스 더 남아 있습니다.
SELinux가 활성화되지 않은 클러스터는 아무 영향도 받지 않습니다. 더 알아보려면 SELinux 볼륨 레이블 변경의 GA 전환과 v1.37에서 예상되는 영향을 확인합니다.
이 작업은 SIG Storage가 주도한 KEP #1710의 일환으로 진행되었습니다.
스테이블로 승격된 DRA 기능
DRA: 표준화된 네트워크 인터페이스 데이터를 담을 수 있는 ResourceClaim 상태
쿠버네티스 v1.37에서 ResourceClaim의 .status.devices가 스테이블에 도달합니다. 이를 통해 드라이버는 리소스 클레임에
할당된 각 장치마다 장치별 상태 데이터를 보고할 수 있습니다. 덕분에 장치가 어떻게 구성되었는지 확인하고, 문제를
해결하고, 다른 서비스와 함께 장치를 사용하기가 쉬워집니다.
이는 특히 네트워크 장치에 유용합니다. 이 필드가 추가되기 전에는 파드가 DRA를 통해 네트워크 장치를 요청해도, 시스템의 다른 어떤 컴포넌트도 그 네트워크 장치에 할당된 IP 주소를 알아낼 방법이 없었습니다. 새 상태 필드는 DRA 드라이버가 그 정보를 필요로 하는 컴포넌트에 내보내는 표준 방법을 제공하며, 이로써 파드에 보조 네트워크 인터페이스를 붙이는 용도로 DRA를 온전히 사용할 수 있게 됩니다.
이 작업은 SIG Node와 SIG Network가 주도한 KEP #4817의 일환으로 진행되었습니다.
DRA: DRA 드라이버를 통한 확장 리소스 요청 처리
쿠버네티스 v1.37에서 DRA 확장 리소스 지원이 스테이블에 도달합니다. 이 기능을 사용하면 DRA 드라이버가 파드 스펙의
abc.example/gpu: 3처럼 전통적인 확장 리소스 메커니즘으로 들어온 요청을, 별도의
장치 플러그인 없이 처리할 수 있습니다.
이 메커니즘을 사용하면 확장 리소스 이름을 DeviceClass에 직접 할당할 수 있습니다. 해당 리소스를 요청하는 파드는 워크로드에 ResourceClaim을 정의하지 않고도 DRA를 통해 장치를 할당받을 수 있습니다.
이 작업은 SIG Scheduling이 주도한 KEP #5004의 일환으로 진행되었습니다.
DRA: 장치 테인트와 톨러레이션
DRA로 관리되는 물리 장치에 대한 테인트(taint)와 톨러레이션(toleration) 지원이 쿠버네티스 v1.37에서 스테이블이 됩니다. 기본적으로는 사용 가능한 모든 장치가 스케줄링 대상이 됩니다. 이번 개선으로 DRA 드라이버가 특정 장치를 테인트된 것으로 표시해 그 장치가 워크로드에 선택되지 않도록 할 수 있어, 장치 스케줄링을 더 세밀하게 제어할 수 있습니다. 또는 클러스터 관리자가 DeviceTaintRule을 만들어, 특정 드라이버가 관리하는 모든 장치처럼 특정 선택 기준에 따라 장치에 테인트를 표시할 수도 있습니다.
이 작업은 SIG Scheduling이 주도한 KEP #5055의 일환으로 진행되었습니다.
DRA: 표준 numaNode 장치 속성
쿠버네티스 v1.37은 새로운 표준 NUMA 노드 장치 속성을 정의합니다. 장치의 NUMA 노드 정보를 담는 공유 속성 이름으로
resource.kubernetes.io/numaNode를 표준화하여, 서로 다른 DRA 드라이버가 관리하는 장치들을 같은 NUMA 노드를 기준으로
비교할 수 있게 합니다. 이로써 드라이버마다 속성 이름을 따로 정의하는 일을 피하고, 장치 전반에서 NUMA 배치를 일관되게
식별하는 방법을 제공합니다. 이 개선은 기능 게이트나 인-트리 동작 변경이 없는 명명 및 등록 KEP이라 곧바로 스테이블로
반영됩니다.
이 작업은 SIG Node가 주도한 KEP #6072의 일환으로 진행되었습니다.
노드 선언 기능
노드 선언 기능이 쿠버네티스 v1.37에서 스테이블로 승격되어, 기능 게이트로 제어되는 특정 쿠버네티스 기능을 노드가 사용할 수 있는지 선언하는 프레임워크를 제공합니다.
컨트롤 플레인 컴포넌트(kube-scheduler, 어드미션 컨트롤러, API 서버 자체 등)는 이를 사용해 버전 차이를 관리하게 됩니다.
이 기능은 노드에 새 .status.declaredFeatures 필드를 도입합니다. 이 필드는 알파 → 베타 → 스테이블 단계를 거치는
기능을 선언하는 데 사용됩니다. 컨트롤 플레인은 이를 활용해 서로 다른 노드 버전이 섞여 있는 클러스터에서도
올바른 동작을 채택할 수 있습니다.
기능이 스테이블로 승격되고 지원되는 버전 차이 범위 안에서 모든 노드가 그 기능을 지원한다고 컨트롤 플레인이 가정할 수 있게 되면, 노드는 해당 기능 보고를 중단합니다.
kubelet은 시작할 때 기능 게이트와 노드의 정적 구성만을 근거로 선언할 기능을 결정합니다(따라서
변경하려면 kubelet을 재시작해야 합니다).
이 작업은 SIG Node가 주도한 KEP #5328의 일환으로 진행되었습니다.
스토리지 버전 마이그레이터
쿠버네티스 v1.37에서 StorageVersionMigration API(storagemigration.k8s.io/v1)가 스테이블로 승격되고 기본적으로
활성화됩니다. 이 API는 선호 스토리지 버전이 v1beta1에서 v1로 바뀌는 경우처럼 API 업그레이드 이후에, 내장
리소스와 커스텀 리소스를 이전 스토리지 버전에서 새 스토리지 버전으로 마이그레이션하도록 돕습니다. 저장 데이터
암호화 설정을 바꾼 뒤 기존 데이터를 다시 기록해 새 암호화 설정으로 저장되게 하는 데에도 쓸 수 있습니다.
지금까지 클러스터 관리자와 커스텀리소스데피니션(CustomResourceDefinition) 작성자는 기존 리소스를 다시 기록하기 위해 kubectl get이나
kubectl replace 스크립트를 수동으로 쓰거나, 아웃-오브-트리 kube-storage-version-migrator 컴포넌트를 배포해야 했습니다.
이런 방식은 대개 번거롭고, 실수하기 쉬우며, 모니터링하기도 어려웠습니다.
스토리지 버전 마이그레이션을 시작하려면 선언적인 StorageVersionMigration 오브젝트를 만들면 됩니다. 쿠버네티스 컨트롤
플레인에 내장된 StorageVersionMigrator 컨트롤러가 이 오브젝트를 감시하다가, 기존 리소스를 해당 API의 기본 스토리지
버전으로 자동 마이그레이션합니다. StorageVersionMigration은 표준 쿠버네티스 API이므로, CRD 작성자는 마이그레이션을
따로 관리하는 대신 CRD 업그레이드의 일부로 실행할 수 있습니다.
이 작업은 SIG API Machinery가 주도한 KEP #4192의 일환으로 진행되었습니다.
스테이블: 파드 인증서와 클러스터 트러스트 번들
파드 인증서와 밀접하게 연관된 ClusterTrustBundle이 쿠버네티스 v1.37에서 함께 스테이블로 승격되어, 파드에 개인 키와 X.509 인증서, 트러스트 번들을 배포하는 기능을 정식으로 지원합니다.
이 기능을 사용하려면 개발자나 관리자가 서명자 이름을 정하고 서명자 컨트롤러를 배포합니다. 이 컨트롤러는
PodCertificateRequest 오브젝트를 감시하고, 자격을 갖춘 파드에 인증서를 발급하고 갱신하며, 해당 인증서를 검증하는 데 필요한 트러스트 앵커를 담은 ClusterTrustBundle 오브젝트를 관리합니다.
그러면 워크로드는 선택한 서명자 이름으로 podCertificate 프로젝티드 볼륨을 정의해 이 아이덴티티를 사용하겠다고 선언합니다. 워크로드는 트러스트 앵커 정보를 불러오기 위해 ClusterTrustBundle 프로젝티드 볼륨을 마운트할 수도 있습니다.
이 작업은 SIG Auth가 주도한 두 개의 KEP, KEP #4317과 KEP #3257의 일환으로 진행되었습니다.
베타로 승격된 기능들
쿠버네티스에서의 갱 스케줄링(gang scheduling) 지원
쿠버네티스가 AI/ML 워크로드를 대규모로 관리하는 사실상의 표준이 되면서, AI/ML 학습 잡이나 HPC 시뮬레이션 같은 워크로드를 스케줄링하는 일이 그 어느 때보다 중요해졌습니다. 그런데 기본 쿠버네티스 스케줄러는 파드를 하나씩 개별로 스케줄링하기 때문에, 일부 파드는 스케줄링되고 나머지는 리소스가 부족해 보류 상태로 남는 상황이 생길 수 있어 스케줄링이 까다로워집니다. 이런 부분 스케줄링은 교착 상태와 클러스터 리소스의 비효율적인 사용으로 이어질 수 있습니다.
갱 스케줄링이 쿠버네티스 v1.37에서 베타로 승격되어, 워크로드 API와 파드그룹 개념을 통한 갱 스케줄링 네이티브 지원이 개선됩니다. 이 기능은 전부 아니면 전무(all-or-nothing) 스케줄링 전략을 구현해, 정의된 파드 그룹 전체를 수용할 만큼 클러스터에 리소스가 충분할 때만 그 그룹이 스케줄링되도록 보장합니다. 이번 베타 승격에서는 워크로드가 진행되는 데 도움이 되지 않는 성급한 선점을 피하기 위한 워크로드 인지 선점과, 경쟁하는 워크로드를 더 잘 조율하기 위한 파드그룹 큐잉도 함께 도입됩니다.
무엇보다도 여러 워크로드가 kube-scheduler에 의해 동시에 스케줄링될 때 발생할 수 있는 라이브락(livelock) 상황을 해결해, 워크로드들이 진전 없이 서로를 반복해서 방해하는 일을 막습니다.
이 작업은 SIG Scheduling이 주도한 KEP #4671의 일환으로 진행되었습니다.
쿠버네티스 메트릭의 네이티브 히스토그램 지원
쿠버네티스는 컨트롤 플레인 컴포넌트 전반에서 수백 개의 히스토그램 메트릭을 프로메테우스 형식으로 노출하며, 이 메트릭은 클러스터 상태를 모니터링하고 성능 문제를 디버깅하는 데 필수적입니다. 그런데 클래식 프로메테우스 히스토그램은 정적이고 미리 정의된 버킷에 의존해서 데이터 정확도와 메모리 사용량 사이에서 타협해야 했습니다. 이를 완화하기 위해 프로메테우스는 고정 경계 대신 동적 지수 버킷 경계를 사용하는 네이티브 히스토그램을 도입했습니다. 네이티브 히스토그램은 기존 모니터링 인프라와의 하위 호환성을 온전히 유지하면서도 저장 효율을 크게 높이고, 쿼리 성능을 개선하며, 분포를 더 세밀하게 들여다볼 수 있게 합니다.
쿠버네티스 v1.37은 쿠버네티스 메트릭의 네이티브 히스토그램 지원을 베타로 승격합니다. NativeHistograms 기능 게이트를
도입했던 알파 구현을 바탕으로, 베타 단계에서는 구현과 롤아웃 경험을 개선했습니다. 이 기능을 활성화하면 요청된 스크랩
프로토콜이 네이티브 히스토그램을 지원할 때(구체적으로는 PrometheusProto) 쿠버네티스 컴포넌트가 히스토그램을 클래식
형식과 네이티브 형식 양쪽으로 노출하므로, 사용자가 각자의 속도로 마이그레이션하는 동안 기존 대시보드와 알림이 계속 동작할 수
있습니다. 또한 init() 함수에서 만들어지던 히스토그램을 지연 초기화를 쓰도록 리팩터링하여, 기능 게이트가 파싱된 뒤에
네이티브 히스토그램 옵션이 올바르게 적용되도록 했습니다. 이런 변경으로 구현의 신뢰성이 높아졌고, 프로메테우스 3.x
사용자를 위해 기능 게이트나 프로메테우스 쪽 구성을 통한 안전한 롤아웃과 롤백은
그대로 유지됩니다.
이 작업은 SIG Instrumentation이 주도한 KEP #5808의 일환으로 진행되었습니다.
WAS: 베타로 승격된 기능들
워크로드 인지 선점
쿠버네티스는 전통적으로 파드 단위로 선점을 수행하는데, 서로 긴밀하게 결합된 여러 파드로 이루어진 워크로드에는 비효율적일 수 있습니다. 쿠버네티스 v1.37에서 워크로드 인지 선점이 베타로 승격되어, 스케줄러가 선점을 결정할 때 파드그룹을 고려할 수 있게 됩니다. 덕분에 스케줄러는 우선순위가 낮은 워크로드를 선점할 때 워크로드를 하나의 전체로 보게 되고, 워크로드가 진행되기에 충분한 용량을 확보하지도 못한 채 개별 파드만 중단되는 경우가 줄어듭니다.
이 작업은 SIG Scheduling이 주도한 KEP #5710의 일환으로 진행되었습니다.
DRA: 워크로드를 위한 ResourceClaim 지원
동적 리소스 할당(Dynamic Resource Allocation, DRA)은 파드가 ResourceClaim을 통해 특수한 리소스를 요청할 수 있게 합니다. 쿠버네티스 v1.37에서 워크로드를 위한 DRA ResourceClaim 지원이 베타로 승격되어, 워크로드 API와 파드그룹 API가 ResourceClaim과 ResourceClaimTemplate을 파드 그룹에 연결할 수 있게 됩니다. 이로써 ResourceClaim을 파드마다 따로 예약하지 않고 워크로드 전체에서 공유할 수 있고, ResourceClaimTemplate은 파드그룹을 위한 클레임을 자동으로 만들 수 있습니다.
이 작업은 SIG Scheduling이 주도한 KEP #5729의 일환으로 진행되었습니다.
cAdvisor 없이 CRI만으로 얻는 컨테이너와 파드 통계
kubelet은 지금까지 컨테이너와 파드 통계를 cAdvisor에서 얻어 왔고, 컨테이너 런타임 인터페이스(Container Runtime
Interface, CRI)는 자체 통계를 따로 노출합니다. 같은 메트릭의 출처가 둘이면 특정 값이 어디에서 왔는지
알기 어려워집니다.
쿠버네티스 v1.37에서 cAdvisor 없이 CRI만으로 컨테이너와 파드 통계를 얻는 개선이 베타로 승격됩니다. 이 개선은
쿠버네티스에 필요한 컨테이너와 파드 통계를 CRI가 제공하도록 확장하여, kubelet이 cAdvisor에 의존하지 않고
컨테이너 런타임에서 이 메트릭을 직접 가져올 수 있게 합니다.
이로써 컨테이너와 파드 메트릭이 하나의 신뢰할 수 있는 출처로 모이고, 중복된 메트릭 수집이 줄어들며,
kubelet이 이 통계를 모아 노출하는 방식도 단순해집니다.
이 기능은 v1.37에서 베타이지만 기본적으로 꺼져 있습니다. 사용해 보려면 PodAndContainerStatsFromCRI 기능 게이트를 활성화합니다.
이 작업은 SIG Node가 주도한 KEP #2371의 일환으로 진행되었습니다.
cgroups v2를 사용한 메모리 QoS 지원
쿠버네티스는 워크로드의 메모리 보호와 격리까지 다루도록 서비스 품질 메커니즘을 개선하고 있습니다. 리눅스로 동작하는 노드에서 메모리 QoS 기능은 메모리 요청과 제한을 사용해 cgroup 제어를 구성하는데, 이를 통해 요청한 메모리를 회수로부터 보호하고 워크로드가 하드 제한에 도달하기 전에 메모리 사용을 쓰로틀할 수 있습니다. 이렇게 하면 메모리에 민감한 워크로드가 메모리 압박에서 받는 영향을 줄이고 노드 안정성을 높이는 데 도움이 됩니다.
쿠버네티스 v1.37에서 메모리 QoS 지원이 베타로 승격됩니다. 이 기능은 memory.min, memory.low, memory.high 같은
cgroups v2 메모리 제어를 사용해 서로 다른 수준의 메모리 보호와 쓰로틀링을 제공합니다. 예를 들어 메모리 요청은
메모리를 회수로부터 보호하는 데 쓸 수 있고, memory.high는 설정된 임계값을 넘는 워크로드를 쓰로틀하는 데
쓸 수 있습니다.
MemoryQoS 기능 게이트는 v1.37에서 기본적으로 활성화됩니다. 클러스터 운영자는 kubelet의 memoryReservationPolicy
설정으로 메모리 보호를 제어하고 memoryThrottlingFactor로 메모리 쓰로틀링을 구성할 수 있습니다. 기본값은 v1.37로
업그레이드할 때 기존 워크로드에 예기치 않은 메모리 쓰로틀링이 생기지 않도록 하면서도, 운영자가 추가 메모리 보호
기능을 선택해 쓸 수 있도록 설계되었습니다.
이 작업은 SIG Node가 주도한 KEP #2570의 일환으로 진행되었습니다.
파드 수준 리소스 매니저
쿠버네티스 v1.37에서 파드 수준 리소스 매니저가 PodLevelResourceManagers 기능 게이트를 통해 베타로 승격되며,
이 게이트는 기본적으로 비활성화된 상태입니다. 이 게이트를 활성화하면 토폴로지, CPU, 메모리 리소스
매니저가 할당과 NUMA 정렬을 결정할 때 파드 전체에 정의된 리소스를
사용할 수 있습니다. 덕분에 파드를 하나의 리소스 단위로 관리하면서도, 그 안의 컨테이너마다 서로 다른 리소스 요구 사항을 지원할 수 있습니다.
파드 수준 리소스 관리를 사용하면 파드가 전체 리소스 예산을 기준으로 NUMA 정렬된 CPU와 메모리 풀을 예약할 수 있습니다. 전용 리소스가 필요한 컨테이너는 그 풀에서 독점 몫을 받고, 사이드카(sidecar)나 보조 워크로드 같은 다른 컨테이너는 남은 리소스를 공유할 수 있습니다. 이는 AI/ML이나 고성능 컴퓨팅처럼 성능에 민감한 워크로드에 특히 유용한데, 파드 안의 모든 컨테이너에 전용 리소스를 주지 않고도 리소스를 같은 NUMA 노드에 가깝게 유지해 성능을 높일 수 있기 때문입니다.
이 기능은 컨테이너 스코프도 지원해서, 컨테이너가 계속 독립적인 NUMA 정렬 할당을 받을 수 있습니다. 성능에 민감한 컨테이너와 리소스 요구 사항이 다른 컨테이너를 함께 쓰는 워크로드에 더 큰 유연성을 제공합니다.
이 작업은 SIG Node가 주도한 KEP #5526의 일환으로 진행되었습니다.
watch 기반 라우트 컨트롤러 조정
cloud-controller-manager 라이브러리의 라우트 컨트롤러는 지금까지 고정된 간격으로, 기본적으로 10초마다 라우트를 조정했습니다. 이 방식은 아무것도 바뀌지 않았을 때조차 인프라 제공자에게 불필요한 요청을 보낼 수 있었고, 새 노드가 추가될 때 라우트 갱신이 늦어질 수도 있었습니다.
watch 기반 라우트 컨트롤러 조정이 쿠버네티스 v1.37에서 베타로 승격되었습니다. 이번 릴리스에서는 이 작업에 대한 가시성(observability)도 추가되었습니다. 라우트 컨트롤러의 알파 route_sync_total 메트릭에 trigger(periodic 또는 node_change)와 outcome(changed, noop, error) 두 레이블이 추가되어, 운영자는 주기적인 조정이 실제로 라우트 드리프트를 바로잡고 있는지 아니면 아무 일도 하지 않고 도는지 확인할 수 있고, 실패한 조정도 추적할 수 있습니다.
watch 기반 라우트 컨트롤러 조정을 사용하면 라우트 컨트롤러가 다음 고정 간격을 기다리는 대신 watch 이벤트로부터 라우트를 조정할 수 있습니다. 노드가 추가되거나 제거될 때, 또는 노드의 주소나 할당된 파드 CIDR이 바뀔 때처럼 관련된 노드 변경이 발생하는 즉시 조정을 시작할 수 있습니다. 오래된 라우트를 잡아내고 상태를 일관되게 유지하기 위한 주기적 조정도 빈도를 낮춰 계속 돕니다. 이 동작은 CloudControllerManagerWatchBasedRoutesReconciliation 기능 게이트 뒤에 있고 기본적으로 비활성화되어 있어서, 이번 전환으로 기본 동작이 바뀌지는 않았습니다.
이로써 인프라 제공자에게 보내는 불필요한 요청이 줄어들고, 새로 추가된 노드의 라우트는 더 빨리 조정됩니다. 이 변경은 라우트 조정 로직 자체를 바꾸지 않습니다. 조정이 언제 트리거되는지를 바꿉니다.
이 작업은 SIG Cloud Provider가 주도한 KEP #5237의 일환으로 진행되었습니다.
노드의 스토리지 용량 점수 산정
VolumeBinding 스케줄러 플러그인은 정적으로 바인딩된 PV에 대해 남은 용량을 기준으로 노드에 점수를 늘 매길 수 있었지만, 그 점수 산정이 동적 프로비저닝까지 확장된 적은 없었습니다.
CSI 드라이버가 필요할 때마다 새 볼륨을 프로비저닝하는 경우, 스케줄러는 남은 공간이 더 많은 노드나 더 적은 노드를 선호할 방법이 없었습니다.
이는 로컬 스토리지에서 아쉬운 지점이었습니다. 관리자는 나중에 볼륨을 확장할 여지를 남기려고 남은 용량이 가장 많은 노드에 파드를 배치하고 싶을 수도 있고, 워크로드를 빈 패킹해서 클라우드 클러스터가 돌려야 할 노드 수를 줄이려고 남은 용량이 가장 적으면서도 충분한 노드에 배치하고 싶을 수도 있기 때문입니다.
쿠버네티스 v1.37은 동적 프로비저닝에 대한 스토리지 용량 점수 산정을 StorageCapacityScoring 기능 게이트를 통해
베타로 승격합니다. v1.33에서 알파로 처음 도입된 이 기능은 KEP #1845의
오래된 VolumeCapacityPriority 게이트를 통합하고 사용 중단시킵니다. 활성화하면 VolumeBinding 플러그인의
Score 익스텐션 포인트가 드라이버의 외부 프로비저너 사이드카가 발행한 CSIStorageCapacity 오브젝트를 읽어,
정적 바인딩에 이미 하고 있는 것과 같은 방식으로 동적 프로비저닝에 대해서도 노드에 점수를 매깁니다. 관리자는
VolumeBindingArgs의 Shape 설정으로 전략을 고르며, 기본값은 "할당 가능한 용량이 가장 큰 노드를 선호"라서
나중에 확장할 여지를 남깁니다.
이 기능은 오직 StorageCapacityScoring 게이트에만 의존합니다. 정적으로 바인딩된 PV에 대한 점수 산정은 게이트를
활성화하는 즉시 어떤 CSI 드라이버와도 무관하게 동작합니다. 드라이버는 CSIDriver 오브젝트에
StorageCapacity: true만 설정하면 동적으로 프로비저닝된 볼륨도 용량을 고려한 점수 산정을 받습니다. 이 기능은
완전히 되돌릴 수 있고, 게이트를 비활성화하면 정적이든 동적이든 VolumeBinding의 모든 용량 점수 산정이 멈추며
이미 스케줄링된 파드에는 영향을 주지 않습니다.
이 작업은 SIG Storage가 주도한 KEP #4049의 일환으로 진행되었습니다.
CSI 볼륨 연결 한도와 클러스터 오토스케일러 통합
쿠버네티스 v1.37은 클러스터 오토스케일러와 CSI 볼륨 연결 한도의 통합을 개선하여, 보류 중인 파드를 위해 새 노드를
만들 때 CSI 볼륨을 사용하는 보류 파드를 모두 연결하려면 새 노드가 몇 개나 필요한지 클러스터 오토스케일러가 더
정확하게 판단할 수 있게 합니다. 클러스터 오토스케일러는 기존 노드의 CSI 볼륨 연결 한도는 이미 파악하고 있었지만
앞으로 만들 노드에 대해서는 그렇지 못했고, 그래서 스케일 업 규모를 실제보다 적게 잡아 용량을 늘린 뒤에도 볼륨을
쓰는 파드가 보류 상태로 남을 수 있었습니다. 스케줄링 쪽에서는 문제가 더 복잡해집니다. NodeVolumeLimits 플러그인은 발행된 CSI 드라이버 정보가 없는 노드를 아무 한도도 없는 노드로 취급하기 때문에, 아직 CSINode 오브젝트를 보고하지 않은 갓 만들어진 노드에 실제로 마운트할 수 있는 것보다 많은 볼륨 사용 파드가 몰릴 수 있는데, 이는 지금까지 클러스터 관리자가 막을 방법이 없던 경합 조건입니다.
쿠버네티스 v1.37은 CSI를 인지하는 오토스케일링을 v1.35에서 알파로 처음 도입된 VolumeLimitScaling 기능 게이트를 통해 베타로 승격합니다. 이제 클러스터 오토스케일러는 템플릿화된 CSINode 오브젝트를 기준으로 스케일 업 시뮬레이션을 돌리므로, 기존 노드 그룹을 확장하든 0에서부터 확장하든 연결 한도를 올바르게 반영합니다. 스케줄러 쪽에서는 관리자가 새 PreventPodSchedulingIfMissing 필드를 통해 CSIDriver 단위로 옵트인해, 아직 드라이버를 보고하지 않은 노드에 파드가 배치되지 않도록 막을 수 있고, 전용 CSIDriverMissingOnNode와 CSINodeMissing 오류 덕분에 이런 스케줄링 실패를 디버깅하기가 쉬워집니다. 베타 단계에서는 스케일 다운 동작과 CSI 옵트인 시나리오에 대한 e2e 커버리지가 추가되고, failed_scale_ups_total과 scaled_up_nodes_total 메트릭에 CSI 드라이버 정보가 포함되도록 갱신됩니다. 오토스케일러와 스케줄러 변경은 모두 철저히 옵트인 방식입니다. 기능 게이트를 비활성화하면 CSINode 데이터가 없는 노드에 파드를 무제한으로 배치하던 오늘날의 기본 동작으로 돌아가므로, 아직 CSI를 인지하지 못하는 오토스케일러(예: Karpenter)를 쓰는 배포판과 관리자가 새 동작을 강요받지 않습니다.
이 작업은 SIG Autoscaling이 주도한 KEP #5030의 일환으로 진행되었습니다.
PVC의 마지막 사용 시각 보고
PersistentVolumeClaim은 자신을 만든 워크로드보다 오래 남는 경향이 있습니다. 앱이 삭제되거나 마이그레이션되면 그 PVC는 뒤에 남아 스토리지를 소비하고 비용을 늘립니다.
쿠버네티스 v1.37은 PVC "마지막 사용(last used)" 추적을 PersistentVolumeClaimUnusedSinceTime 기능 게이트를 통해 베타로 승격합니다. 이 게이트는 알파(v1.36)에서 기본 비활성화로 출시되었고 이제 기본적으로 활성화됩니다. 이 기능은 PersistentVolumeClaimStatus에 새 Unused 컨디션을 추가하며, 기존 PVC 보호 컨트롤러가 이를 관리합니다. PVC를 참조하는 마지막 비종료(non-terminal) 파드가 사라지면 Status=True (Reason=NoPodsUsingPVC)가 되고, 파드가 다시 참조하기 시작하면 곧바로 Status=False (Reason=PodUsingPVC)로 돌아갑니다. 이 컨디션의 lastTransitionTime은 "미사용 시작 시각" 타임스탬프 역할도 겸하므로, 관리자는 쿠버네티스가 어떤 파드가 마지막으로 썼는지 추적하거나 삭제를 스스로 결정하지 않고도 PVC가 실제로 얼마나 오래 유휴 상태였는지 조회할 수 있습니다. 삭제 결정은 전적으로 관리자의 몫입니다. 한 가지 유의할 점은 이 타임스탬프가 인프라 수준에서 볼륨이 마운트 해제된 정확한 시점이 아니라 컨트롤러가 PVC를 쓰는 파드가 없음을 관측한 시점을 반영한다는 것입니다. 그래서 보고된 유휴 시간이 실제보다 조금 짧을 수는 있어도 길게 나오지는 않습니다.
이 작업은 SIG Storage가 주도한 KEP #5541의 일환으로 진행되었습니다.
etcd RangeStream 지원
etcd의 단항 Range RPC는 응답 전체를 메모리에 만든 뒤에 돌려주는데, 규모가 커지면 이것이 문제가 됩니다. 큰 클러스터에서 kube-apiserver의 watch 캐시가 준비되는 경우처럼 목록이 클 때는 원본 키-값 슬라이스와 직렬화된 protobuf 형태, gRPC 전송 버퍼가 한꺼번에 메모리에 공존해야 하고, 그로 인한 급증이 kube-apiserver까지 파급됩니다. 페이지네이션(pagination)도 근본적인 비용을 해결해 주지는 못합니다. 페이지마다 전체 결과 개수를 다시 계산하려고 B-트리 인덱스 전체를 순회하므로, O(limit)이어야 할 연산이 페이지마다 O(total_keys)가 되기 때문입니다.
쿠버네티스 v1.37은 etcd RangeStream 지원을 EtcdRangeStream 기능 게이트를 통해 곧바로 베타로 제공합니다(kube-apiserver 전용, 기본적으로 켜짐).
이번 릴리스는 기존 RangeRequest를 재사용하되 버퍼에 담긴 덩어리 하나가 아니라 청크를 반환하는 새 서버 스트리밍 RangeStream RPC를 추가합니다. 서버는 적응형 청크 크기 조절로 내부에서 페이지를 나누고(각 청크의 목표 크기는 MaxRequestBytes와 지금까지 관측한 값 크기를 바탕으로 조정됩니다), 단일 MVCC 리비전을 고정해 병합된 스트림이 스냅샷 일관성을 유지하게 하며, 전체 키 개수는 별도의 인덱스 순회 대신 스트리밍하면서 누적한 집계에서 구합니다.
kube-apiserver의 watch 캐시 초기화가 주된 사용처인데, 이제 전체 목록을 메모리에 먼저 모으지 않고 청크가 도착하는 대로 각 청크를 합성 created 이벤트로 인라인 디코딩하며, WatchList가 비활성화된 경우의 직접 GetList 호출에도 같은 방식이 적용됩니다.
이 기능은 etcd 3.7 이상이 필요합니다. 더 낮은 etcd를 쓰면 kube-apiserver가 Unimplemented 응답을 감지해 자동으로 단항 Range로 폴백하며, 동작은 전혀 달라지지 않습니다. 고정된 리비전이 스트림 도중에 압축되면 kube-apiserver는 다른 watch 캐시 초기화 실패와 똑같이 취급해 재시도하는데, 이는 오늘날 페이지네이션된 List 호출이 이미 겪을 수 있는 압축 경합보다 나쁘지 않습니다. 베타 승격 기준에는 5000 노드 클러스터에서 큰 목록의 지연 시간을 측정하는 확장성 테스트가 포함되며, 새 RPC를 직접 만져 보고 싶은 사람을 위해 etcdctl get --stream도 함께 제공됩니다.
이 작업은 SIG etcd가 주도한 KEP #5966의 일환으로 진행되었습니다.
동시 watch 오브젝트 디코드
kube-apiserver는 etcd에서 오는 모든 watch 이벤트를 단일 고루틴에서 하나씩 디코딩하고 변환하기 때문에, 이벤트별 변환 하나가 느려지면(대표적으로 CRD 컨버전 웹훅 호출) 그 뒤에 줄 선 모든 이벤트가 막힙니다. 내장 리소스에서는 대체로 성가신 정도지만, 제공 버전이 저장 버전과 다른 CRD라면 콜드 캐시(cold cache)를 직렬로 변환하는 데 몇 분이 걸릴 수 있습니다. 이 시간이 etcd의 기본 5분 압축 간격을 넘기면 캐시가 읽기 시작한 리비전이 초기화가 끝나기 전에 압축되어 watch를 재개할 수 없고, 초기화가 다시 시작되기만 할 뿐 충분히 큰 리소스에서는 끝내 수렴하지 못하며, 그동안 그 리소스를 list 하거나 watch 하려는 모든 클라이언트는 오류를 받습니다.
ConcurrentWatchObjectDecode 게이트는 사실 v1.31부터 기본 비활성화 상태로 베타였고, 쿠버네티스 v1.37에서 기본 활성화로 전환됩니다. 이 게이트를 켜면 디코딩과 변환 단계가 단일 고루틴이 아니라 개수가 제한된 워커 고루틴 풀(기본 10개이며, 이득이 8~12 부근에서 평탄해지는 것을 확인한 스윕 결과로 정했습니다)에서 실행되고, 수집기가 이벤트를 전달 전에 원래 순서로 다시 조립하므로 이벤트 순서는 정확히 보존됩니다. 15만 개 파드 규모의 벤치마크에서 동시 디코드만으로 캐시 초기화 시간이 약 40% 줄었고, 이번 릴리스에 함께 들어온 새 EtcdRangeStream 기능과 합치면 약 55% 줄었습니다(KEP 5966 참고). 주의해서 볼 절충점은 컨버전 웹훅 부하입니다. 이 기능을 켜면 캐시 초기화 동안 웹훅에 대한 변환이 하나씩이 아니라 최대 10개까지 동시에 실행될 수 있습니다. 전체 호출량은 그대로이고 동시에 도는 개수만 달라지므로, 이는 자체 동시성을 10 미만으로 제한하는 웹훅에서 주로 문제가 됩니다.
이 작업은 SIG API Machinery가 주도한 KEP #6178의 일환으로 진행되었습니다.
컨트롤러의 오래된 상태 완화
kube-controller-manager의 모든 컨트롤러는 kube-apiserver를 감시해서 만든 로컬 캐시를 기반으로 동작하는데, 그
watch 스트림은 최종적 일관성만 보장합니다. 변경이 밀리초 만에 드러날 수도 있고, 부하가 걸리면 몇 초에서 몇 분까지
걸릴 수도 있습니다. 지금은 운영자가 그 지연을 들여다볼 방법도, 정상적인 지연과 위험할 만큼 동기화가 어긋난
컨트롤러를 구분할 방법도 없어서, 컨트롤러가 이미 오래된 세계관을 기준으로 계속 조정(reconciling)할 수 있습니다.
컨트롤러의 오래된 상태 완화는 v1.36부터 베타였고 StaleControllerConsistency<Controller> 기능 게이트 뒤에서 컨트롤러마다
기본 활성화되어 있습니다. 쿠버네티스 v1.37은 이를 HorizontalPodAutoscaler 컨트롤러까지 확장하고, 아래에 설명하는
서킷 브레이킹 변형과 추가 메트릭을 더합니다. 핵심 메커니즘은 자신의 쓰기에 대한 읽기 일관성(read your writes) 보장입니다. client-go의
ResourceEventHandlerFuncs에 새 BookmarkFunc 콜백이 추가되어, 기존 add/update/delete 콜백이 놓치는 경계 사례에서도
컨트롤러가 관심 있는 오브젝트의 리소스 버전을 확실히 추적할 수 있습니다. 컨트롤러는 자신이 쓴 내용의 리소스 버전을
기록해 두었다가, 다음 조정 때 인포머 캐시가 그 쓰기를 실제로 따라잡을 때까지 건너뛰고 다시 큐에 넣습니다.
데몬셋(DaemonSet) 컨트롤러가 좋은 예입니다. 데몬셋 → 파드 리소스 버전을 추적해서 자기 자신의 오래된 파드 캐시를 기준으로 다시
조정하지 않습니다. 두 번째인 서킷 브레이킹 변형은 node-lifecycle처럼 지연에 민감한 컨트롤러를 겨냥합니다. 이런
컨트롤러는 캐시에서 오래된 노드 리스를 읽고 만료되었다고 잘못 판단할 수 있는데, 대신 파급이 큰 결정을 내릴 때
실시간 GET을 수행하고 캐시가 따라잡을 때까지 캐시를 "준비되지 않음"으로 표시해 오래된 읽기를 근거로 행동하지
않습니다. StaleControllerConsistency는 완화 기능 자체를 제어하고(처음에는 KCM이 대규모로 분류한 컨트롤러에
한정됩니다), MonitorInformerStaleness는 인포머 캐시가 실제로 얼마나 뒤처져 있는지 드러내려고 5초마다 API 서버를
직접 폴링하는 관측 전용 게이트이며, AtomicFIFO와 UnlockWhileProcessingFIFO는 이 완화가 의존하는 client-go
워크큐 배관입니다. 이 중 어느 것도 기본 리컨실러 동작을 바꾸지 않습니다. 멈췄다가 다시 큐에 들어간 컨트롤러는
실제로는 캐시를 기다리는 중인데도 멈춘 것처럼 보일 수 있고, 되돌릴 수 없는 일을 하지 않으므로 깔끔하게
롤백됩니다.
이 작업은 SIG API Machinery가 주도한 KEP #5647의 일환으로 진행되었습니다.
매니페스트 기반 어드미션 컨트롤 구성
쿠버네티스에서 어드미션 컨트롤은 리소스가 API 서버에 받아들여지기 전에 정책을 적용하는 일을 맡습니다. 그런데 쿠버네티스 API를 통해 구성된 어드미션 웹훅과 정책은 클러스터가 시작하는 동안 API 서버와 etcd에 의존하며, 어드미션 구성 리소스 자체를 보호하지도 못합니다. 이 때문에 클러스터 부트스트랩 구간에 빈틈이 생기고, 충분한 권한을 가진 사용자가 중요한 어드미션 정책을 수정하거나 제거할 수 있습니다.
쿠버네티스 v1.37에서 매니페스트 기반 어드미션 컨트롤 구성이 베타로 승격되어, 어드미션 웹훅과 CEL 기반
정책을 디스크의 매니페스트 파일에서 불러와 API 서버 시작 시점부터 적용할 수 있습니다. 이 구성은 쿠버네티스 API와 별개로 관리되므로, API 기반 어드미션 리소스가 변경되지 않도록 보호할 수도 있습니다. 매니페스트 파일은 변경을 감시하다가 유효한 갱신이 들어오면 자동으로 다시 불러오고, 유효하지 않은 갱신이 들어오면 이전에 불러온 구성을 그대로 둡니다.
이 작업은 SIG API Machinery가 주도한 KEP #5793의 일환으로 진행되었습니다.
복호화할 수 없는 리소스 처리 개선
쿠버네티스는 리소스를 etcd에 저장하며, 민감한 데이터를 보호하기 위해 저장 데이터 암호화를 사용할 수 있습니다. 그런데 암호화된 리소스를 더 이상 복호화할 수 없게 되면, 예를 들어 암호화 키를 사용할 수 없게 되면 API 서버가 그 리소스를 정상적으로 읽거나 관리할 수 없습니다. 그러면 쿠버네티스 API로는 접근할 수 없는 리소스가 클러스터에 남고, 관리자가 복구하려면 기반 etcd 데이터를 직접 수정해야 합니다.
쿠버네티스 v1.37에는 API 서버가 복호화할 수 없는 리소스를 클러스터 관리자가 식별하고 제거할 수 있도록 하는 베타 지원이 포함됩니다.
쿠버네티스 v1.32에서 알파로 도입되었던 이 지원을 사용하면 etcd 파일을 직접 조작하는 대신
쿠버네티스 API를 통해 문제가 되는 API 리소스를 제거할 수 있습니다. 또한 관리자가 삭제 전에 영향을 받는 리소스를 확인할 수 있도록 안전장치도 제공합니다.
이 작업은 SIG Auth가 주도한 KEP #3926의 일환으로 진행되었습니다.
알파로 승격된 신규 기능
스테이트풀셋(StatefulSet) 롤아웃을 위한 새로운 Recreate 전략
쿠버네티스 v1.37은 스테이트풀셋 롤아웃을 위한 Recreate 전략을 도입합니다. 지금까지 스테이트풀셋 API는 OnDelete(수동)와
RollingUpdate(자동, 기본값)라는 두 가지 업데이트 전략만 제공했습니다. 디플로이먼트(Deployment)와 비슷하게, Recreate 업데이트 전략은
스테이트풀셋의 파드를 모두 삭제한 뒤, 스테이트풀셋의 .spec.template에 가해진 수정 사항을 반영하는 새 파드를 생성합니다.
이 전략을 사용하려면 StatefulSetRecreateStrategy 기능 게이트를 활성화해야 합니다.
이 작업은 SIG Apps가 주도한 KEP #3541의 일환으로 진행되었습니다.
DRA: 주목할 만한 알파 기능
DRA: 노드 할당 가능 리소스 요청
쿠버네티스 v1.37은 DRA를 통해 CPU, 메모리, huge page 같은 노드 리소스를 관리하는 알파 지원을 개선합니다. 표준 리소스 집계와 DRA 리소스 집계를 통합해, 같은 노드 용량이 두 번 계산되는 일을 막는 데 도움을 줍니다.
이번 업데이트는 mapping(CPU/메모리 DRA 드라이버처럼 코어 리소스를 직접 모델링하는 장치용)과 overhead(가속기 장치를 위한 보조 호스트 메모리 등)라는 서로 구별되는 API 필드를 도입합니다. 이제 kubelet은 이 할당을 파드와 컨테이너 cgroup 전반에 적용하고, 메모리 QoS, OOM 점수 계산, 인플레이스(in-place) 파드 리사이즈와 통합합니다.
이 작업은 SIG Node가 참여한 가운데 SIG Scheduling이 주도한 KEP #5517의 일환으로 진행되었습니다.
DRA: 파생 속성
쿠버네티스 v1.37은 DRA의 파생 속성(derived attributes)에 대한 알파 지원을 도입합니다. 워크로드는 CEL 표현식을 사용해 장치 정보로부터 가상 속성을 만들고, 관련된 장치를 선택할 때 이를 사용할 수 있습니다.
덕분에 드라이버가 서로 다른 속성 이름이나 형식을 사용하더라도 GPU와 네트워크 인터페이스 같은 장치를 같은 위치에 배치하기가 더 쉬워집니다. 예를 들어 워크로드는 공유 NUMA 식별자를 파생시킨 뒤, 이를 사용해 토폴로지가 일치하는 장치를 선택할 수 있습니다.
이 작업은 SIG Network가 참여한 가운데 SIG Scheduling이 주도한 KEP #6080의 일환으로 진행되었습니다.
DRA: 장치 호환성 그룹
DRA는 서로 다른 파티션 방식이나 가상화 방식을 지원하는 장치를 관리하는 데 사용할 수 있습니다. 그런데 GPU의 MIG와 vGPU처럼 이런 구성 중 일부는 같은 물리 장치에서 함께 사용할 수 없습니다. 지금까지 이런 비호환성은 스케줄러가 이미 결정을 내린 뒤인 장치 준비 단계에서야 감지할 수 있었습니다.
쿠버네티스 v1.37에서 DRA는 장치 호환성 그룹을 추가해, 리소스 드라이버가 어떤 장치를 함께 할당할 수 있는지 기술할 수 있게 합니다. 스케줄러는 할당을 결정할 때 이 정보를 사용할 수 있으며, 이로써 불완전한 장치가 함께 배정되는 것을 막고 불완전한 장치 구성 때문에 생기는 파드 시작 실패를 피할 수 있습니다.
이 작업은 SIG Scheduling이 주도한 KEP #5963의 일환으로 진행되었습니다.
인플레이스 파드 리사이즈를 위한 스케줄러 선점
쿠버네티스 v1.37은 (옵트인, 알파) InPlacePodVerticalScalingSchedulerPreemption 기능 게이트를 통해 인플레이스 파드 리사이즈를 위한 스케줄러 선점을 도입합니다. 이 변경은 핵심 기능인 인플레이스 파드 수직 스케일링이 스테이블로 승격된 뒤에도 남아 있던 중요한 기능 공백을 해결합니다. 실행 중인 파드가 노드의 가용 용량을 넘어서는 추가 리소스를 요청하면 kubelet은 그
요청을 Deferred로 표시했고, 파드는 노드에 리소스가 충분해질 때까지 기다려야 했습니다. 이번 개선으로 쿠버네티스 컨트롤
플레인은 완전히 사용 중인 노드에서 능동적으로 용량을 확보하고 우선순위가 낮은 워크로드를 선점할 수 있게 되어, 중요하고
우선순위가 높은 애플리케이션의 대기 중인 인플레이스 리사이즈가 성공할 수 있습니다.
이 작업은 SIG Scheduling이 주도한 KEP #5836의 일환으로 진행되었습니다.
메모리 기반 볼륨의 동적 크기 조정
인플레이스 파드 수직 스케일링을 기반으로 하는 또 하나의 기능인 알파 단계의 메모리 기반 볼륨을 위한 인플레이스 스케일링은 파드의
/resize 서브리소스를 확장합니다. 이 서브리소스는 지금까지 컨테이너를 재시작하지 않고 CPU와 메모리를 동적으로 조정하는
것만 지원했는데, 이제 실행 중인 파드에서 메모리 기반(medium: Memory) emptyDir 볼륨의 sizeLimit 업데이트까지 지원합니다.
볼륨의 sizeLimit이 /resize 서브리소스를 통해 명시적으로 조정되면, kubelet은 컨테이너를 중단하지 않고 그 아래의 tmpfs
마운트를 동적으로 업데이트하며, 그러면서도 메모리 부족 오류나 오탐(false-positive)으로 인한 축출 트리거를 안전하게 막습니다. 이는 인메모리 임시
스토리지에 의존하는 스테이트풀 워크로드와 메모리 집약적인 워크로드에 특히 유용하며, 파드 재시작이나 애플리케이션 다운타임
없이 컨테이너 메모리 용량과 함께 스토리지 한도를 동적으로 조정할 수 있게 해줍니다.
이 기능은 옵트인 방식이며 기본적으로 꺼져 있는 알파 기능입니다. 사용해 보려면
InPlacePodVerticalScalingMemoryBackedVolumes 기능 게이트를 활성화합니다.
이 작업은 SIG Node와 SIG Storage가 주도한 KEP #6030의 일환으로 진행되었습니다.
노드를 위한 특화된 라이프사이클 관리
여러 쿠버네티스 컴포넌트가 노드의 라이프사이클 상태를 파악해야 하는데, 지금은 저마다 노드 준비 상태, 테인트, 파드 상태,
레이블, 어노테이션, 프로바이더 API를 서로 다르게 조합해 이를 추론합니다. 이번 개선은 노드에 잘 알려진 라이프사이클
컨디션을 도입해, 핵심 컨트롤러와 생태계 도구가 사용할 수 있는 라이프사이클 상태를 관리자가 게시할 쿠버네티스 소유의
단일한 자리를 제공합니다. 새로 추가되는 노드 컨디션은 DrainInProgress, Drained, MaintenancePlanned, MaintenanceInProgress, GracefulNodeShutdownInProgress입니다.
이 작업은 SIG Node가 주도한 KEP #5683의 일환으로 진행되었습니다.
WAS: 주목할 만한 알파 기능
CompositePodGroup API
이전 릴리스가 단층 구조인 워크로드의 갱 스케줄링 지원을 도입했다면,
오늘날의 AI/ML 워크로드는 복잡하고 더 정교한 스케줄링 요구 사항이
있습니다. 쿠버네티스 v1.37의 새로운 알파 CompositePodGroup API는
쿠버네티스가 복잡한 워크로드를 단층으로 나열된 파드 집합이 아니라
그룹의 계층 구조로 기술할 수 있게 합니다. 이를 통해 다단계 갱 스케줄링,
워크로드 인지 선점, 토폴로지 인지 스케줄링이 가능해집니다.
이 작업은 SIG Scheduling이 주도한 KEP #6012의 일환으로 진행되었습니다.
워크로드 인지 스케줄링 컨트롤러 API
쿠버네티스 v1.37은 알파 기능으로, 워크로드 컨트롤러(JobSet, TrainJob, LWS, RayJob 등)는 물론 Job 같은 핵심 워크로드까지 워크로드 인지 스케줄링(Workload-aware Scheduling, WAS)과 통합하기 위한 공통 프레임워크를 제공합니다.
이 프레임워크는 토폴로지 제약과 중단 정책 같은 재사용 가능한 scheduling.k8s.io API 프리미티브와, 스케줄링 리소스
생성을 처리하는 공유 라이브러리를 제공합니다. 덕분에 컨트롤러는 같은 스케줄링 로직을 따로 구현하지 않고도 자신의 API
안에서 WAS 기능을 일관된 방식으로 네이티브하게 노출할 수 있습니다.
이 작업은 SIG Scheduling이 주도한 KEP #6089의 일환으로 진행되었습니다.
잡(Job) 컨트롤러와 워크로드 API 통합
쿠버네티스 v1.36에서 제한된 기능으로 처음 도입되었던 이 기능은 워크로드 인지 스케줄링 컨트롤러 API를 기반으로, 쿠버네티스 v1.37에서 batch/v1 잡에 사용자용 spec.scheduling 필드를 새로 추가합니다. 이를 통해 사용자는
스케줄링 정책, 토폴로지 제약, 중단 모드, 리소스 클레임을 명시적으로 구성할 수 있습니다. spec.scheduling을 생략하면
잡은 Basic 스케줄링을 기본값으로 사용해 기존 동작을 유지하면서도, minCount 게이트를 강제하지 않고 워크로드 인지
스케줄링을 위한 Basic 워크로드/파드그룹을 그대로 생성합니다. 사용자는 Gang 스케줄링을 명시적으로 선택할 수 있는데,
이 경우 minCount는 잡의 parallelism 값을 기본값으로 하고, 컨트롤러는 별도의 변환 로직을
구현하는 대신 공유 workloadbuilder 라이브러리를 사용해 스케줄링 구성을 그에 대응하는
워크로드와 파드그룹 오브젝트로 변환합니다.
이 작업은 SIG Scheduling이 주도한 KEP #5547의 일환으로 진행되었습니다.
nftables를 위한 localhost NodePort 유저스페이스(userspace) 프록시
쿠버네티스 v1.37은 nftables kube-proxy 백엔드에 옵트인 방식의 유저스페이스 프록시를 추가해, IPv4와 IPv6에서
localhost를 통해 NodePort 서비스에 접근할 수 있게 합니다. 이로써 nftables와 iptables 백엔드 사이의 차이가 해소됩니다.
지금까지 nftables는 localhost NodePort를 서빙할 수 없었기 때문입니다.
이 프록시는 kube-proxy의 --nodeport-addresses 구성에 localhost나 루프백 주소가 포함되어 있을 때 활성화됩니다.
localhost:<NodePort> 연결에 의존하는 로컬 컨테이너 레지스트리 같은 워크로드에 유용할 수 있습니다. iptables와 ipvs
백엔드의 기존 동작은 바뀌지 않습니다.
이 작업은 SIG Network가 주도한 KEP #6032의 일환으로 진행되었습니다.
기타 주목할 만한 변경 사항
스테이트풀셋의 maxUnavailable 기본 활성화 복귀
스테이트풀셋의 maxUnavailable 필드가 쿠버네티스 v1.37에서 기본적으로 다시 활성화되었습니다(v1.36에서 버그가
발견된 이후).
이 버그는 결함이 있는 최초 스테이트풀셋 리비전이 끝내 준비 상태가 되지 않는 파드를 만들었을 때 발생했으며,
MaxUnavailableStatefulSet이 활성화된 상태에서 스테이트풀셋 컨트롤러가 그 파드를 더 새롭고 수정된 리비전으로
업데이트하지 못했습니다. 이 버그가 발생하면 영향을 받은 파드가 CrashLoopBackOff 상태에 무기한 갇힐 수 있었습니다(kubernetes#137409 참고).
nftables 성능 개선
이제 kube-proxy는 nftables 규칙 작업에 nft 커맨드라인 도구를 우회하고 커널의 netlink 인터페이스를 사용합니다. 덕분에 kube-proxy가 자신의 nftables 규칙을 조회하고 관리할 때 더 효율적으로 동작하며, 규칙 관리 성능이 개선됩니다.
client-go의 컨텍스트 처리와 컨텍스츄얼 로깅
client-go의 컨텍스트 전파와 컨텍스츄얼 로깅 지원이 완료되었습니다. 다만 하위 API가 컨텍스트 전달을 지원하지 않아 여전히 전역 klog 로거에 의존하는 소수의 인증 플러그인 로그 호출은 여기에서 제외됩니다.
v1.37의 승격, 사용 중단 및 제거
스테이블로 승격
스테이블(general availability라고도 함)로 승격된 모든 기능을 정리했습니다. 신규 기능과 알파에서 베타로 승격된 항목까지 포함한 전체 목록은 릴리스 노트를 참고합니다.
이번 릴리스에는 스테이블로 승격된 개선 사항이 총 16개 포함됩니다.
- 재귀적 SELinux 레이블 변경 속도 향상
- ClusterTrustBundles
- 파드 인증서
- 파드의 호스트네임으로 임의의 FQDN 설정 허용
- DRA: 표준화된 네트워크 인터페이스 데이터를 담을 수 있는 ResourceClaim 상태
- HorizontalPodAutoscaler의 구성 가능한 허용 오차
- 서비스 이름에 대한 완화된 검증
- 장치 플러그인과 DRA를 위한 파드 상태에 리소스 헬스 상태 추가
- DRA: 장치 테인트와 톨러레이션
- DRA: DRA 드라이버를 통한 확장 리소스 요청 처리
- 노드 선언 기능
- 샌드박스 생성 컨디션 추가
- 스토리지 버전 마이그레이터를 인-트리로 이동
- 견고한 watch 캐시 초기화
- DRA: 표준 numaNode 장치 속성
- metrics.k8s.io API 정의
- KYAML
사용 중단, 제거 및 커뮤니티 업데이트
쿠버네티스가 발전하고 성숙해짐에 따라, 프로젝트의 전반적인 상태를 위해 기능이 사용 중단되거나, 제거되거나, 더 나은 기능으로 대체될 수 있습니다. 이 과정에 대한 자세한 내용은 쿠버네티스 사용 중단 및 제거 정책을 참고합니다. 이러한 사용 중단과 제거 중 다수는 사용 중단 및 제거 블로그에서 공지되었습니다.
kube-dns 사용 중단
CoreDNS는 쿠버네티스 v1.13부터 기본 클러스터 DNS 애드온이며, kube-dns는 그 이후로 발전을 따라가지 못했습니다. 엔드포인트슬라이스(EndpointSlice)나 이중 스택 서비스 같은 기능은 이 애드온에서 사용할 수 없습니다.
쿠버네티스는 이미 kube-dns 하위 프로젝트를 은퇴시켰고, node-local-dns를 별도 리포지터리로 분리했습니다. 그곳에서 node-local-dns는 계속 유지보수되며 CoreDNS와 함께 동작합니다. v1.40 이후로는 kube-dns용 새 패키지가 빌드되지 않을 것으로 예상됩니다.
아직 kube-dns를 운영하고 있다면, 클러스터를 CoreDNS로 마이그레이션할 계획을 세우기 시작합니다.
kube-proxy의 ipvs 모드 지원 사용 중단
ipvs 모드에 대한 kube-proxy 지원은 iptables 성능 병목을 해결하기 위해 v1.8에서 도입되었습니다. 그런데 커널
ipvs API만으로는 쿠버네티스 서비스를 온전히 구현할 수 없어서, ipvs 모드는 그 아래에서 여전히 iptables를 사용합니다
(KEP-3866, "kube-proxy의 ipvs 모드는 우리를 구해주지 못한다").
ipvs 모드로(또는 KubeProxyConfiguration에서 mode: ipvs로) kube-proxy를 실행하는 클러스터는 이제 시작 시 사용 중단 경고를 기록합니다. 사용 중단 일정은 다음과 같습니다.
- v1.40까지
kube-proxy의ipvs모드는 기본적으로 비활성화될 예정입니다(기능 게이트로는 여전히 선택 가능). - v1.43까지
ipvs모드 지원은 완전히 제거될 예정입니다 KEP #5495, 승격 기준. 현재 어떤 모드로 실행 중인지 확인하려면 다음을 사용합니다.
kubectl -n kube-system get configmap kube-proxy -o jsonpath='{.data.config\.conf}' | grep 'mode:'
이 사용 중단의 배경을 이해하려면 KEP #5495를 참고합니다.
kubectl: kubectl run --filename/-f 사용 중단 예정
kubectl run의 --filename(또는 -f) 플래그가 사용 중단됩니다. 생성되는 파드가 언제나 NAME과 --image 같은 CLI 인자만으로 만들어지기 때문입니다.
원래 이슈와 논의는 kubernetes/kubernetes#138671을 참고합니다.
kubelet: 스태틱(static) 파드는 더 이상 시크릿(Secret)이나 컨피그맵(ConfigMap)을 참조할 수 없음
스태틱 파드는 API 서버를 통해 생성되지 않으므로 API 리소스를 직접 읽도록 만들어진 적이 없습니다. 그런데 버그 때문에 configMapRef나 secretRef 같은 필드로 시크릿이나 컨피그맵을 참조할 수 있었습니다. 이 버그는 이제 수정되어, v1.37부터 이러한 참조는 엄격히 금지되고, 이전에는 이 제한에서 빠져나갈 수 있게 해주던 PreventStaticPodAPIReferences 기능 게이트도 제거되었습니다.
원래 이슈와 논의는 kubernetes/kubernetes#140226을 참고합니다.
진행 중인 주요 변경: 향후 cgroup v1 지원 제거
최신 리눅스 배포판과 컨테이너 런타임이 cgroup v2를 기본으로 사용하면서,
레거시 cgroup v1 지원은 공식적으로 폐지 수순을 밟고 있습니다. v1.35 릴리스부터 failCgroupV1 설정의 기본값은
true입니다. 따라서 명시적인 구성 재정의를 적용하지 않으면 kubelet은 여전히 cgroup v1에 의존하는 노드에서
초기화에 실패합니다.
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
failCgroupV1: false # 임시 재정의
이 재정의를 사용하는 것은 단기적인 임시방편으로 여겨야 합니다. 메모리 QoS나 메모리 기반 볼륨을 위한 인플레이스 스케일링 같은 고급 리소스 관리 기능은 cgroups v2에서만 동작합니다. 재정의는 쿠버네티스 v1.37에서도 계속 사용할 수 있지만, cgroups v1 지원은 향후 릴리스에서 제거될 예정이므로 cgroups v2로 마이그레이션할 것을 권장합니다.
이 사용 중단에 대해 더 알아보려면 KEP #5573을 참고합니다.
릴리스 노트
쿠버네티스 v1.37 릴리스의 전체 세부 사항은 릴리스 노트를 확인합니다.
다운로드 및 시작하기
쿠버네티스 v1.37은 쿠버네티스 다운로드 페이지에서, 또는 GitHub에서 직접 다운로드할 수 있습니다.
쿠버네티스를 시작하려면 튜토리얼을 참고하거나 minikube를 사용해 로컬 쿠버네티스 클러스터를 실행합니다. kubeadm을 사용해 v1.37을 쉽게 설치할 수도 있습니다.
릴리스 팀
쿠버네티스는 커뮤니티의 지원, 헌신, 그리고 노력 없이는 불가능합니다. 각 릴리스 팀은 여러분이 의존하는 쿠버네티스 릴리스를 구성하는 수많은 조각을 만들기 위해 함께 일하는 헌신적인 커뮤니티 자원봉사자들로 이루어져 있습니다.
여기에는 코드 자체부터 문서화와 프로젝트 관리에 이르기까지, 커뮤니티 곳곳의 사람들이 가진 전문 기술이 필요합니다.
쿠버네티스 v1.37 릴리스를 커뮤니티에 전달하기 위해 수많은 시간을 들여 열심히 작업해 준 전체 릴리스 팀에 감사드립니다.
릴리스 팀의 구성원은 처음 참여한 섀도우부터 여러 릴리스 주기를 거치며 경험을 쌓은 복귀 팀 리드까지 다양합니다.
성공적인 릴리스 주기 내내 우리를 지원하고, 대변하고, 모두가 각자 최선의 방식으로 기여할 수 있도록 살펴주고, 릴리스 프로세스를 개선하도록 북돋아 준 릴리스 리드 Dipesh Rawat에게 특별한 감사를 전합니다.
프로젝트 속도
CNCF K8s DevStats 프로젝트는 쿠버네티스와 다양한 하위 프로젝트의 개발 속도와 관련된 여러 흥미로운 데이터를 집계합니다.
여기에는 개인 기여부터 기여하는 회사 수까지 모든 것이 포함되며, 이 생태계를 발전시키는 데 들어가는 노력의 깊이와 폭을 보여줍니다.
2026년 5월 18일부터 2026년 8월 26일까지 15주 동안 이어진 v1.37 릴리스 주기 동안, 쿠버네티스에 대한 기여는 최대 212개의 서로 다른 회사와 1,754명의 개인에 이르렀습니다.
이 데이터의 출처:
"기여"는 누군가 커밋, 코드 리뷰, 댓글을 하거나, 이슈 또는 PR을 만들거나, PR(블로그와 문서 포함)을 리뷰하거나 이슈와 PR에 댓글을 달 때를 뜻합니다.
기여에 관심이 있다면 시작하기 페이지를 확인합니다.
이벤트 업데이트
전 세계에서 열릴 예정인 KubeCon 행사를 살펴봅니다.
- KubeCon + CloudNativeCon China: 2026년 9월 7-9일, 중국 상하이
- KubeCon + CloudNativeCon North America: 2026년 11월 9-12일, 미국 솔트레이크시티
2026년 남은 기간에 열릴 예정인 Kubernetes Community Days(KCD)를 살펴봅니다.
2026년 9월
- KCD x Ceph x OpenInfra Day Korea: 2026년 9월 1일, 대한민국 서울
- KCD San Francisco Bay Area: 2026년 9월 1일, 미국 마운틴뷰
- KCD Washington DC: 2026년 9월 15일, 미국 워싱턴 D.C.
- KCD Gujarat: 2026년 9월 19일, 인도 아마다바드
- KCD São Paulo: 2026년 9월 26일, 브라질 상파울루
- KCD Sofia: 2026년 9월 29일, 불가리아 소피아
2026년 10월
- KCD UK – Edinburgh: 2026년 10월 19-20일, 영국 에든버러
- KCD Nigeria: 2026년 10월 24일, 나이지리아 라고스
2026년 11월
- KCD Porto: 2026년 11월 19-20일, 포르투갈 포르투
- KCD Hangzhou: 2026년 11월 28일, 중국 항저우
2026년 12월
- KCD Suisse Romande: 2026년 12월 9-10일, 스위스 메랭
- KCD Provence: 2026년 12월 10일, 프랑스 엑상프로방스
- KCD Florida – Miami: 2026년 12월 11일, 미국 마이애미
최신 이벤트 세부 사항은 CNCF 이벤트 페이지에서 확인할 수 있습니다.
예정된 릴리스 웨비나
쿠버네티스 v1.37 릴리스 팀 멤버들과 함께 2026년 9월 23일 수요일 오후 4:00(UTC)에 이번 릴리스의 주요 내용을 알아봅니다. 자세한 정보와 등록은 CNCF Online Programs 사이트의 이벤트 페이지에서 확인합니다.
참여 방법
쿠버네티스에 참여하는 가장 쉬운 방법은 관심 분야에 맞는 여러 SIG(Special Interest Group) 중 하나에 가입하는 것입니다.
어디서부터 시작할지 모르겠다면, 매달 열리는 신규 기여자 오리엔테이션에 참여해 보세요. 여기에서 프로젝트가 어떻게 구성되어 있는지 커뮤니티에 알려 드리고, 프로젝트에 첫 기여를 하는 방법을 안내합니다.
- 쿠버네티스 기여자가 되는 방법을 더 읽어봅니다.
- 블로그에서 쿠버네티스에 무슨 일이 일어나고 있는지 더 읽어봅니다.
- Slack에서 함께합니다.
- 최신 소식을 받아보려면 Bluesky에서 팔로우합니다.
- LinkedIn에서 팔로우합니다.
- (https://x.com/kubernetesio)에서 팔로우합니다.
- Discuss에서 커뮤니티 토론에 참여합니다.
- Stack Overflow에서 질문을 올리거나 답변합니다.
- 여러분의 쿠버네티스 최종 사용자 스토리를 공유합니다.
- 쿠버네티스 릴리스 팀에 대해 더 알아봅니다.