Kubernetes v1.37: ガルワール (Garhwal)
編集者: Arsh Sharma、Christopher Tineo、Kirti Goyal、Sophia Ugochukwu、Swathi Rao、Troy Connor
これまでのリリースと同様に、Kubernetes v1.37のリリースでは、新しいGA、ベータ、アルファの機能が導入されます。 高品質なリリースの継続的な提供は、私たちの開発サイクルの強さとコミュニティからの活発なサポートを示しています。
このリリースは67件の機能強化で構成されています。 そのうち、16件がGAに昇格し、23件がベータに昇格し、27件がアルファとして導入され、1件が非推奨化/削除されます。
リリースのテーマとロゴ
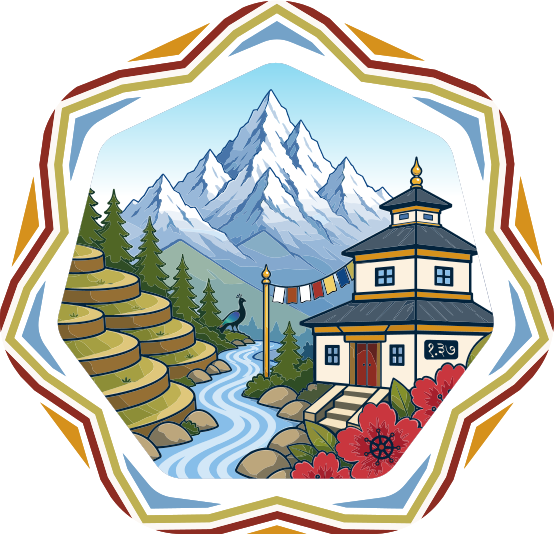
Kubernetes v1.37のテーマはガルワール(गढ़वाल、発音: gaṛhvāl)です。 インド・ウッタラカンド州のヒマラヤ地方です。 雪を頂いたガルワールヒマラヤの峰々、デオダーの森、段々畑、川や小川、山道が、この地域とロゴの両方を形作っています。 これらの要素が一体となって、あらゆるレイヤー、経路、貢献がつながっているコミュニティを反映しています。
ロゴはガルワールの風景を覗く窓として構想されています。1 中には、雪の峰に向かって登る段々畑があり、各段は下の段によって支えられています。 これは、すべてのKubernetesリリースが前の作業の上に成り立っているのと同じです。 谷を曲がりくねって流れる川は山の小川を集め、多くのSIGやコミュニティからの貢献が一つのプロジェクトへと流れ込む様子を表しています。
デオダーの森は、異なるプロジェクトが共通の基盤を共有し、並んで成長する、より広範なKubernetesエコシステムを象徴しています。 石造りと木工が道と山小屋を形作り、人々を中心に置き、後を継ぐ人々のために守られてきた共有の基盤を思い起こさせます。 川の上では、色とりどりの旗が風をとらえ、風景に命を吹き込んでいます。
風景を取り囲むのは、柔軟な矮性ヒマラヤ竹である ringaal から織られた籠細工に着想を得た模様のフレームです。 個々の細い帯は互いに絡み合うことで強度を得ます。 これは、コード、レビュー、テスト、ドキュメント、そして調整が一体となってリリースを作り上げるのと同じです。
フレームの内側には、ウッタラカンド州の州鳥であるニジキジが、ヒマラヤの高地に生息しています。 その虹色の羽毛は一度に多くの色を放ちます。 これは、Kubernetesコミュニティが多くのスキルと視点を一つのプロジェクトにもたらすのと同じです。 ウッタラカンド州の州木である赤い シャクナゲ(buransh、Rhododendron arboreum)の花は、その中心にKubernetesの舵輪を冠し、ガルワールで馴染み深い花とコミュニティが共有するシンボルを結びつけています。 山小屋には१.३७(デーヴァナーガリー数字の1.37)と記され、リリースを風景に根付かせています。
1. 窓(ロゴ)をじっと見続けてください。川の流れと風に揺れる旗を眺めてください。37秒後、風景はその魔法を明らかにします。😉
主なアップデート情報
Kubernetes v1.37は新機能と改善点が満載です。 ここでは、リリースチームが特に注目してほしい、選りすぐりのアップデートをご紹介します!
安定版: Resilient watchcache initialization
Kubernetes v1.37は、resilient watch cache initialization(回復力のあるwatchキャッシュ初期化)の作業を完了します。
ResilientWatchCacheInitializationフィーチャーゲートはv1.34でGAに到達し、v1.37では残りのWatchCacheInitializationPostStartHookゲートがGAに昇格して、有効の状態でロックされます。
このゲートはv1.36以降デフォルトで有効であり、起動時と復旧時のAPIサーバーを強化します。
Watchキャッシュの初期化と再初期化は、etcdに対するリクエストのトラフィックスパイクを発生させなくなり、キャッシュのウォームアップ中にリクエストが蓄積されることなく、正常に処理されるようになります。
高コストなlistおよびwatchリクエストがetcdを過負荷にしたり、API Priority and Fairnessの容量を枯渇させたりすることを許可するのではなく、kube-apiserverは現在、制限されたリクエストを安全に委譲し、それ以外のリクエストをHTTP 429レスポンスで拒否します。
これにより、大規模クラスターにおけるコントロールプレーンの停止リスクが低減します。
クライアント(カスタムコントローラーやオペレーターを含む)は、Retry-Afterヘッダーを尊重し、指数バックオフを実装することで、HTTP 429 Too Many Requestsレスポンスを正常に処理できるように設計する必要があります。
この取り組みは、SIG API Machineryが主導したKEP #4568の一環として行われました。
ベータ: HorizontalPodAutoscalerによるゼロへのスケーリング
Kubernetes v1.37では、HorizontalPodAutoscalerの scale to zero(ゼロへのスケーリング)サポートがベータに昇格します。
Kubernetes v1.16で初めて導入されたこの機能は、現在はデフォルトで有効です。
オブジェクトまたは外部メトリクスを使用するワークロードでは、この機能によりHorizontalPodAutoscalerがアイドル時にPodをゼロまでスケールダウンし、需要が戻ったときにそれらを復元できるようになります。
これにより、キューのコンシューマー、バッチジョブ、GPUワークロードのコストを削減できます。
spec.minReplicas: 0を設定すると、ワークロードにこの機能が適用されます。
CPUおよびメモリメトリクスに基づくゼロへのスケーリングは、これらのメトリクスがアクティブなPodに依存しているためサポートされていません。 代わりに、この機能は、処理すべきキューに入った作業があるまでレプリカ数をゼロに保つといった状況を想定しています。
HorizontalPodAutoscalerがワークロードをゼロレプリカで保持している間、HorizontalPodAutoscalerのステータスにScaledToZero ConditionをTrueで記録します。
HorizontalPodAutoscalerコントローラーは、このConditionを使用して、(メトリクスが戻ったときにスケールアップする)ゼロにスケールしたワークロードと、レプリカ数を0に設定することで手動で無効化されたワークロードを区別します。
ワークロードがスケールアップされると、Conditionの理由はNotScaledToZeroでFalseに設定されます。
この取り組みは、SIG Autoscalingが主導したKEP #2021の一環として行われました。
ベータ: マニフェストベースのadmission control設定
Kubernetes v1.37では、マニフェストベースのadmission control設定がベータに昇格します。
Admission webhookとCELベースのポリシーを、Kubernetes API内にのみ置かれるのではなく、AdmissionConfigurationのstaticManifestsDirフィールドを介してディスク上のマニフェストファイルから読み込めるようになります。
この方法で読み込まれたポリシーはAPIサーバーの起動時から適用され、etcdが利用できない間も機能し続け、APIベースのadmissionリソース自体を改変から保護することもできます。
この取り組みは、SIG API Machineryが主導したKEP #5793の一環として行われました。
アルファ: Podレベルのチェックポイントと復元
Kubernetes v1.37では、Podレベルのチェックポイントと復元に対するアルファサポートを導入します。
これは、CheckpointPodとRestorePod RPCを提供することでCRIを拡張し、kubeletと互換性のあるコンテナランタイムがPodのチェックポイントの作成と、そこからPodの復元をできるようにします。
この機能を使用するには、コンテナランタイムがこれらの新しいRPCを実装している必要があります。
この取り組みは、SIG Nodeが主導したKEP #5823の一環として行われました。
GAに昇格した機能
これは安定版(一般提供、GAとも呼ばれる)に昇格したすべての機能を一覧にしたものです。 新機能やアルファからベータへの昇格を含むすべての更新の完全なリストについては、リリースノートをご覧ください。
このリリースには、GAに昇格した合計16件の機能強化が含まれています。
KYAML
KYAML は、Kubernetes専用に設計された、より安全で曖昧さの少ないYAMLのサブセットであり、YAMLの置き換えではありません。
すべてのKYAMLファイルは有効なYAMLであるため、KYAMLは任意のバージョンのkubectlにとって有効な入力であり、入力が解析されるためにspecファイルをKYAMLで記述する必要はありません。
既存のマニフェスト、ツール、パイプラインを変更する必要はありません。
v1.34でアルファ機能として導入され、v1.35でベータに昇格したKYAMLは、適合性テストの完了とともにv1.37でGAに昇格し、kubectl get -o kyamlが現在GAになりました。
KYAMLの詳細については、How to Pretty-Print Your Kubernetes YAML as KYAML and Why You'd Want Toをご覧ください。
この取り組みは、SIG CLIが主導したKEP #5295の一環として行われました。
metrics.k8s.io API
metrics.k8s.io APIは、約9年間のベータ期間を経て、Kubernetes v1.37でGAに昇格します。
このAPIは、PodとノードのCPUおよびメモリ使用量を取得する標準的な方法を提供し、HorizontalPodAutoscaler(HPA)やkubectl topコマンドなど、広く使用されているKubernetes機能を支えています。
この昇格は、永続的なベータAPIを避けるというKubernetesプロジェクトの目標に沿っています。
v1が存在するようになったため、将来のKubernetesリリースはこちらに移行します。
v1beta1は、API非推奨ポリシーに従って移行期間中も引き続き利用可能なため、既存のワークフローを壊すことなくGA APIを採用できます。
この取り組みは、SIG Instrumentationが主導したKEP #5207の一環として行われました。
SELinuxMountとSELinuxChangePolicy
Kubernetes v1.37では、SELinuxMountおよびSELinuxChangePolicyフラグがGAに達し、デフォルトで有効になります。
つまり、ボリュームは再帰的なラベル再設定の代わりに-o context=<label>(MountOptionのデフォルト)でマウントされます。
ただし、これはボリュームのCSIドライバーがCSIDriverオブジェクトの.spec.seLinuxMount: trueを介してオプトインした場合のみです。
マウントは1つのSELinuxコンテキストしか保持できないため、同じノード上で異なるSELinuxラベルを持つPodがボリュームを共有する場合、従来は再帰的なラベル再設定の下では共存できていましたが、今後は起動に失敗する可能性があります。
ワークロードにおいて従来の動作を維持するには、Pod上で.spec.seLinuxChangePolicyをRecursiveに設定することを推奨します。
この動作自体もv1.38まではロックされないため、クラスター全体での無効化は、あと1リリースの間は選択肢として残されています。
SELinuxが有効でないクラスターにはまったく影響がありません。 詳細については、SELinux Volume Label Changes goes GA (and likely implications in v1.37)をご覧ください。
この取り組みは、SIG Storageが主導したKEP #1710の一環として行われました。
GAに昇格したDRA機能
DRA: 標準化されたネットワークインターフェースデータを伴うResourceClaimステータス
ResourceClaimの.status.devicesがKubernetes v1.37でGAに到達し、ドライバーがリソースクレーム内の割り当て済みデバイスごとにデバイス固有のステータスデータを報告できるようになります。
これにより、デバイスがどのように構成されているかの確認、問題発生時のトラブルシューティング、他のサービスと連携したデバイスの使用が容易になります。
これは特にネットワークデバイスにとって有用です。 このフィールドが追加される前は、PodがDRAを介してネットワークデバイスをリクエストした場合、システム内の他のコンポーネントがそのネットワークデバイスに割り当てられたIPアドレスを知る方法がありませんでした。 新しいステータスフィールドは、DRAドライバーがその情報を必要とするコンポーネントにエクスポートする標準化された方法を提供し、DRAをPodへのセカンダリネットワークインターフェースの接続に完全に使用できるようにします。
この取り組みは、SIG NodeとSIG Networkが主導したKEP #4817の一環として行われました。
DRA: DRAドライバーを介した拡張リソースリクエストの処理
Kubernetes v1.37で、DRA拡張リソースサポートがGAに到達します。
この機能により、DRAドライバーは、Pod spec内のabc.example/gpu: 3のような従来の extended resource(拡張リソース)メカニズムを通じて行われたリクエストを、別のデバイスプラグインを必要とせずに満たすことができます。
このメカニズムにより、拡張リソース名をDeviceClassに直接割り当てられます。 そのリソースをリクエストするPodに対しては、ワークロード内でResourceClaimを定義しなくても、DRAを介してデバイスが割り当てられるようになります。
この取り組みは、SIG Schedulingが主導したKEP #5004の一環として行われました。
DRA: デバイスのTaintとToleration
DRAを介して管理される物理デバイスに対する taintとtoleration のサポートが、Kubernetes v1.37でGAになりました。 デフォルトでは、利用可能な任意のデバイスがスケジューリングの候補になり得ます。 この機能強化は、DRAドライバーが特定のデバイスにtaintを付与し、それらをワークロードの選択対象から除外できるようにすることで、デバイスのスケジューリングに対するより高度な制御を提供します。 あるいは、クラスター管理者はDeviceTaintRuleを作成して、特定のドライバーが管理するすべてのデバイスなど、特定の選択基準に基づいてデバイスをtaintできます。
この取り組みは、SIG Schedulingが主導したKEP #5055の一環として行われました。
DRA: 標準的なnumaNodeデバイス属性
Kubernetes v1.37は、新しい標準的な NUMAノードデバイス属性 を定義します。
resource.kubernetes.io/numaNodeをデバイスのNUMAノード情報の共有属性名として標準化し、異なるDRAドライバーによって管理されるデバイスが同じNUMAノードに基づいて比較できるようにします。
これにより、各ドライバーが独自の属性名を定義する必要がなくなり、デバイス全体でのNUMA配置を一貫した方法で識別できます。
この機能強化は、フィーチャーゲートやin-treeの動作変更がない命名・登録KEPであるため、直接GAとなります。
この取り組みは、SIG Nodeが主導したKEP #6072の一環として行われました。
Node declared features
Node declared features は、特定のフィーチャーゲートを備えたKubernetes機能の利用可能性をNodeのために宣言するフレームワークを提供し、Kubernetes v1.37でGAに昇格します。
これは、コントロールプレーンコンポーネント(kube-scheduler、admissionコントローラー、APIサーバー自体など)がバージョンスキューを管理するために使用します。
この機能は、Nodeに新しい.status.declaredFeaturesフィールドを導入し、アルファ→ベータ→GAの段階を通過する機能を宣言するために使用されます。
コントロールプレーンはこれを利用して、異なるノードバージョンが混在するクラスターでも正しい動作を採用できます。
機能がGAに昇格し、コントロールプレーンがサポートされるバージョンスキューの範囲内で全ノードがその機能をサポートすると想定できるようになると、ノードはそれらの報告を停止します。
kubeletは起動時に、フィーチャーゲートとノードの静的な設定のみに基づいて宣言する機能を決定します(そのため、変更にはkubeletの再起動が必要です)。
この取り組みは、SIG Nodeが主導したKEP #5328の一環として行われました。
Storage version migrator
Kubernetes v1.37では、StorageVersionMigration API(storagemigration.k8s.io/v1)がGAに昇格し、デフォルトで有効になります。
これは、APIアップグレード後(推奨ストレージバージョンがv1beta1からv1に変わる場合など)に、既存のリソース(組み込みとカスタムの両方)を古いストレージバージョンから新しいストレージバージョンへ移行するのに役立ちます。
さらに、保存時の暗号化の変更後に既存データを書き換えるためにも使用でき、古いデータが新しい暗号化設定で保存されるようにできます。
かつては、クラスター管理者とCustomResourceDefinitionの作成者は、既存リソースを書き換えるために手動のkubectl getやkubectl replaceスクリプトを使用するか、out-of-treeのkube-storage-version-migratorコンポーネントをデプロイする必要がありました。
これらのアプローチはしばしば面倒で、エラーが発生しやすく、監視も困難でした。
ストレージバージョン移行を開始するには、宣言的なStorageVersionMigrationオブジェクトを作成する必要があります。
Kubernetesコントロールプレーンに組み込まれたStorageVersionMigratorコントローラーはこれらのオブジェクトを監視し、既存のリソースをそのAPIのデフォルトストレージバージョンへ自動的に移行します。
StorageVersionMigrationは標準のKubernetes APIであるため、CRD作成者は移行を別途管理する代わりに、CRDアップグレードの一部として移行をトリガーできます。
この取り組みは、SIG API Machineryが主導したKEP #4192の一環として行われました。
安定版: Pod証明書とCluster Trust Bundles
Pod証明書と密接に関連するClusterTrustBundlesは、どちらもKubernetes v1.37でGAに昇格し、秘密鍵、X.509証明書、トラストバンドルをPodに配布するためのファーストクラスサポートを提供します。
これを使用するには、開発者または管理者が署名者(signer)名を選択し、signer controller をデプロイします。
このコントローラーはPodCertificateRequestオブジェクトを監視し、対象となるPodに対して証明書を発行・更新し、それらの証明書の検証に必要なトラストアンカーを含む対応するClusterTrustBundleオブジェクトを維持します。
ワークロードは、選択した署名者名を持つpodCertificateプロジェクテッドボリュームを定義することで、このアイデンティティにオプトインします。
ワークロードはClusterTrustBundleプロジェクテッドボリュームをマウントしてトラストアンカー情報を読み込むこともできます。
この取り組みは、SIG Authが主導したKEP #4317とKEP #3257の2つのKEPの一環として行われました。
ベータに昇格した機能
KubernetesにおけるGangスケジューリングのサポート
KubernetesがAI/MLワークロードを大規模に管理するためのデファクトスタンダードとなるにつれ、AI/MLの学習ジョブやHPCシミュレーションといったワークロードのスケジューリングは、これまで以上に重要になっています。 しかし、デフォルトのKubernetesスケジューラーはPodを個別にスケジューリングするため、スケジューリングには困難が伴います。 一部のPodがスケジューリングされる一方で、残りはリソース不足のためPendingのままになる、という事態が起こりえます。 このような部分的なスケジューリングは、デッドロックやクラスターリソースの非効率な利用につながります。
Kubernetes v1.37ではGangスケジューリングがベータに昇格し、Workload APIとPodGroupの概念によるGangスケジューリングのネイティブサポートが改善されます。 この機能はオールオアナッシングのスケジューリング戦略を実装しており、定義されたPodのグループ全体を収容できる十分なリソースがクラスターにある場合にのみ、そのグループがスケジューリングされることを保証します。 この機能強化のベータ昇格では、ワークロードの進行に寄与しない早すぎるプリエンプションを避けるためのワークロードを考慮したプリエンプションと、競合するワークロードをより適切に調整するためのPodGroupのキューイングも導入されます。
重要な点として、この機能は複数のワークロードがkube-schedulerによって同時にスケジューリングされる際に発生しうるライブロックのシナリオに対処し、進行しないまま互いに干渉し続けることを防ぎます。
この取り組みは、SIG Schedulingが主導したKEP #4671の一環として行われました。
Kubernetesメトリクスのネイティブヒストグラムのサポート
Kubernetesは、コントロールプレーンのコンポーネント全体で数百のヒストグラムメトリクスをPrometheus形式で公開しています。 これらはクラスターの健全性を監視し、パフォーマンスの問題をデバッグするために不可欠です。 しかし、従来のPrometheusのヒストグラムは静的で事前定義されたバケットに依存しており、データの正確性とメモリ使用量の間で妥協を強いられていました。 これを緩和するため、Prometheusは固定の境界ではなく動的な指数バケット境界を使用するネイティブヒストグラムを導入しました。 これにより、既存の監視インフラストラクチャとの完全な後方互換性を保ちながら、ストレージ効率の大幅な向上、クエリパフォーマンスの改善、そして分布をより細かい粒度で把握できるようになりました。
Kubernetes v1.37では、Kubernetesメトリクスのネイティブヒストグラムのサポートがベータに昇格します。
NativeHistogramsフィーチャーゲートを導入したアルファ実装を基盤として、ベータの段階では実装とロールアウトの体験が改善されます。
有効にすると、リクエストされたスクレイププロトコルがネイティブヒストグラムをサポートしている場合(具体的にはPrometheusProto)、Kubernetesのコンポーネントはヒストグラムを従来形式とネイティブ形式の両方で公開します。
これにより、ユーザーが自身のペースで移行する間も、既存のダッシュボードとアラートは動作し続けられます。
また、この実装ではinit()関数内で作成されるヒストグラムを遅延初期化を使うようにリファクタリングし、フィーチャーゲートがパースされた後にネイティブヒストグラムのオプションが正しく適用されることを保証しています。
これらの変更により、Prometheus 3.xのユーザーはフィーチャーゲートまたはPrometheus側の設定を通じた安全なロールアウトとロールバックを維持しながら、より信頼性の高い実装を利用できます。
この取り組みは、SIG Instrumentationが主導したKEP #5808の一環として行われました。
WAS: ベータに昇格した機能
ワークロードを考慮したプリエンプション
Kubernetesは従来、プリエンプションをPod単位で実行してきましたが、これは密結合した複数のPodで構成されるワークロードにとっては非効率になりえます。 Kubernetes v1.37では、ワークロードを考慮したプリエンプションがベータに昇格し、スケジューラーはプリエンプションを判断する際にPodGroupを考慮できるようになります。 これにより、スケジューラーは優先度の低いワークロードをプリエンプションする際にワークロード全体を考慮できるようになり、ワークロードが進行するのに十分な容量を確保できないまま個々のPodが中断されるケースを減らせます。
この取り組みは、SIG Schedulingが主導したKEP #5710の一環として行われました。
DRA: ワークロードに対するResourceClaimのサポート
Dynamic Resource Allocation(DRA)は、PodがResourceClaimを通じて特殊なリソースを要求できるようにする仕組みです。 Kubernetes v1.37では、ワークロードに対するDRAのResourceClaimのサポートがベータに昇格し、Workload APIとPodGroup APIがResourceClaimおよびResourceClaimTemplateをPodのグループに関連付けられるようになります。 これにより、ResourceClaimはPodごとに個別に予約されるのではなくワークロード全体で共有できるようになり、ResourceClaimTemplateはPodGroupのためのクレームを自動的に作成できます。
この取り組みは、SIG Schedulingが主導したKEP #5729の一環として行われました。
cAdvisorに依存しないCRI完結のコンテナとPodの統計情報
kubeletはこれまで、コンテナとPodの統計情報をcAdvisorから取得してきましたが、Container Runtime Interface(CRI)も独自の統計情報を公開しています。
同じメトリクスに2つの情報源があると、特定の値がどこから来たのかを判別しにくくなります。
Kubernetes v1.37では、cAdvisorに依存しないCRI完結のコンテナとPodの統計情報という機能強化がベータに昇格します。
この機能強化はCRIを拡張してKubernetesが必要とするコンテナとPodの統計情報を提供し、kubeletがこれらのメトリクスをcAdvisorに頼らずコンテナランタイムから直接取得できるようにします。
これにより、コンテナとPodのメトリクスは単一の信頼できる情報源への一本化が進み、メトリクス収集の重複が減り、kubeletがこれらの統計情報を収集して公開する方法も簡素化されます。
この機能はv1.37でベータですが、デフォルトでは無効です。
試すにはPodAndContainerStatsFromCRIフィーチャーゲートを有効にしてください。
この取り組みは、SIG Nodeが主導したKEP #2371の一環として行われました。
cgroup v2によるメモリQoSのサポート
Kubernetesは、ワークロードのメモリの保護と分離を対象とするよう、QoS(Quality of Service)の仕組みを改善しています。 Linuxで動作するノードでは、メモリQoS機能がメモリのrequestsとlimitsを使ってcgroupの制御を設定し、要求されたメモリを回収から保護したり、ワークロードがハードリミットに達する前にメモリ使用量をスロットリングしたりできます。 これは、メモリに敏感なワークロードへのメモリ圧迫の影響を軽減し、ノードの安定性を向上させるのに役立ちます。
Kubernetes v1.37では、メモリQoSのサポートがベータに昇格します。
この機能はmemory.min、memory.low、memory.highといったcgroup v2のメモリ制御を使用して、さまざまなレベルのメモリ保護とスロットリングを提供します。
たとえば、メモリのrequestsはメモリを回収から保護するために使用でき、memory.highは設定されたしきい値を超えたワークロードをスロットリングするために使用できます。
MemoryQoSフィーチャーゲートはv1.37でデフォルトで有効です。
クラスターの管理者は、kubeletのmemoryReservationPolicy設定を通じてメモリ保護を制御し、memoryThrottlingFactorでメモリのスロットリングを設定できます。
デフォルト値は、v1.37へのアップグレード時に既存のワークロードで予期しないメモリのスロットリングが発生しないよう設計されており、同時に管理者が追加のメモリ保護機能をオプトインできるようになっています。
この取り組みは、SIG Nodeが主導したKEP #2570の一環として行われました。
Podレベルのリソースマネージャー
Kubernetes v1.37では、PodレベルのリソースマネージャーがPodLevelResourceManagersフィーチャーゲートの下でベータに昇格しますが、このゲートはデフォルトで無効のままです。
有効にすると、トポロジー、CPU、メモリの各リソースマネージャーが、割り当てとNUMAアライメントを判断する際にPod全体に定義されたリソースを使用できます。
これにより、Pod内のコンテナ間で異なるリソース要件をサポートしつつ、Podを単一のリソース単位として管理できます。
Podレベルのリソース管理では、Podは全体のリソース予算に基づいてNUMAアライメントされたCPUとメモリのプールを予約できます。 専用のリソースを必要とするコンテナはそのプールの排他的な一部を受け取れる一方で、サイドカーや補助的なワークロードといった他のコンテナは残りのリソースを共有できます。 これはAI/MLや高性能計算といったパフォーマンスに敏感なワークロードで特に有用です。 同じNUMAノード上でリソースを互いに近く保つことで、Pod内のすべてのコンテナに専用のリソースを与えなくてもパフォーマンスを向上できます。
この機能はコンテナスコープもサポートしており、コンテナは引き続き独立したNUMAアライメントされた割り当てを受け取れます。 これにより、パフォーマンスに敏感なコンテナと異なるリソース要件を持つ他のコンテナを組み合わせるワークロードに、より高い柔軟性がもたらされます。
この取り組みは、SIG Nodeが主導したKEP #5526の一環として行われました。
watchベースのルートコントローラーの調整
cloud-controller-managerライブラリのルートコントローラーは、以前は固定の間隔(デフォルトでは10秒ごと)でルートを調整していました。 このため、何も変更がない場合でもインフラストラクチャプロバイダーへの不要なリクエストが発生し、新しいNodeが追加されたときにはルートの更新が遅れることもありました。
Kubernetes v1.37では、watchベースのルートコントローラーの調整がベータに昇格しました。
このリリースでは、この取り組みに対する可観測性も追加されます: ルートコントローラーのアルファのroute_sync_totalメトリクスにtrigger(periodicまたはnode_change)とoutcome(changed、noop、error)の2つのラベルが追加され、管理者は定期的な調整が実際にルートのずれを修正しているのか、それとも何もしないまま実行されているだけなのかを確認し、失敗した調整を追跡できます。
watchベースのルートコントローラーの調整では、ルートコントローラーは次の固定間隔を待つのではなく、watchイベントからルートを調整できます。
Nodeの追加や削除、あるいはNodeのアドレスや割り当てられたPod CIDRの変更といった、関連するNodeの変更が発生するとすぐに調整を開始できます。
古くなったルートを捕捉して状態の一貫性を保つため、頻度を落とした定期的な調整も引き続き実行されます。
この動作はCloudControllerManagerWatchBasedRoutesReconciliationフィーチャーゲートの下にあり、デフォルトでは無効のため、この移行によってデフォルトの動作は変わっていません。
これにより、インフラストラクチャプロバイダーへの不要なリクエストが減り、新しく追加されたNodeのルートをより早く調整できます。 この変更はルートの調整ロジック自体を変更するものではなく、調整がトリガーされるタイミングを変更します。
この取り組みは、SIG Cloud Providerが主導したKEP #5237の一環として行われました。
Nodeのストレージ容量スコアリング
VolumeBindingスケジューラープラグインは、静的にバインドされたPVについては以前から空き容量に基づいてNodeをスコアリングできましたが、そのスコアリングが動的プロビジョニングに拡張されることはありませんでした。
CSIドライバーがオンデマンドで新しいボリュームをプロビジョニングする際、スケジューラーには空き容量の多いNodeや少ないNodeを優先する手段がありませんでした。
これはローカルストレージにおける課題でした。 管理者は、後のボリューム拡張の余地を残すために空き容量が最も多いNodeにPodを配置したい場合もあれば、ワークロードをビンパッキングしてクラウドクラスターが稼働させるべきNode数を削減するために、空き容量が最も少ない(それでも十分な)NodeにPodを配置したい場合もあるためです。
Kubernetes v1.37では、動的プロビジョニングのためのストレージ容量スコアリングがStorageCapacityScoringフィーチャーゲートの下でベータに昇格します。
v1.33でアルファとして初めて導入されたこの機能は、KEP #1845による従来のVolumeCapacityPriorityゲートを統合し、非推奨とします。
有効にすると、VolumeBindingプラグインのScore拡張点はドライバーの外部プロビジョナーのサイドカーが公開するCSIStorageCapacityオブジェクトを読み取り、静的なバインドに対してすでに行っているのと同じ方法で、動的プロビジョニングのNodeをスコアリングします。
管理者はVolumeBindingArgsのShape設定で戦略を選択します。
デフォルトは「割り当て可能な容量が最大のNodeを優先する」であり、後の拡張の余地が残されます。
この機能はStorageCapacityScoringゲートのみに依存します: 静的にバインドされたPVのスコアリングは、CSIドライバーとは無関係に、ゲートを有効にした時点で動作します。
ドライバー側は、動的にプロビジョニングされたボリュームにも容量を考慮したスコアリングを適用するために、CSIDriverオブジェクトにStorageCapacity: trueを設定するだけで済みます。
この機能は完全に元に戻せます。
ゲートを無効にすると、静的・動的を問わずVolumeBindingの容量スコアリングはすべて停止しますが、すでにスケジューリングされたPodには影響しません。
この取り組みは、SIG Storageが主導したKEP #4049の一環として行われました。
CSIボリュームのアタッチ上限とクラスターオートスケーラーの統合
Kubernetes v1.37では、クラスターオートスケーラーとCSIボリュームのアタッチ上限との統合が改善されます。
これにより、Pending状態のPodのために新しいNodeを作成する際、クラスターオートスケーラーはCSIボリュームを使用するすべてのPending状態のPodをアタッチするために必要な新規Node数を、より正確に判断できます。
クラスターオートスケーラーは既存のNodeについてはCSIボリュームのアタッチ上限を把握できていましたが、これから作成しようとしているNodeについては把握できていませんでした。
そのためスケールアップが不足し、容量を追加した後でもボリュームを使用するPodがPendingのまま残ることがありました。
この問題はスケジューリング側でさらに悪化します: NodeVolumeLimitsプラグインはCSIドライバーの情報が公開されていないNodeを上限なしとして扱うため、まだCSINodeオブジェクトを報告していない作成直後のNodeに、実際にマウントできる数を超えるボリュームを使用するPodが詰め込まれる可能性があります。
これは競合状態であり、これまでクラスターの管理者には防ぐ手立てがありませんでした。
Kubernetes v1.37では、CSIを考慮したオートスケーリングがVolumeLimitScalingフィーチャーゲートの下でベータに昇格します。
この機能はv1.35でアルファとして初めて導入されました。
クラスターオートスケーラーはスケールアップのシミュレーションをテンプレート化されたCSINodeオブジェクトに対して実行するようになり、既存のNodeグループをスケールする場合でもゼロからスケールする場合でも、アタッチ上限を正しく考慮します。
スケジューラー側では、管理者は新しいPreventPodSchedulingIfMissingフィールドを通じてCSIDriver単位でオプトインし、ドライバーをまだ報告していないNodeへのPodの配置をブロックできます。
専用のCSIDriverMissingOnNodeエラーとCSINodeMissingエラーにより、これらのスケジューリングの失敗をデバッグしやすくなります。
ベータの段階では、スケールダウンの動作とCSIのオプトインのシナリオに対するe2eテストのカバレッジが追加され、failed_scale_ups_totalメトリクスとscaled_up_nodes_totalメトリクスにCSIドライバーの情報が含まれるように更新されます。
オートスケーラーとスケジューラーの変更はいずれも厳密にオプトインのままです: フィーチャーゲートを無効にすると、CSINodeのデータがないNodeへのPodの配置を無制限とする現在のデフォルトに戻るため、まだCSIを考慮していないオートスケーラー(Karpenterなど)を運用しているディストリビューションや管理者が、新しい動作を強制されることはありません。
この取り組みは、SIG Autoscalingが主導したKEP #5030の一環として行われました。
PVCの最終使用時刻の報告
PersistentVolumeClaimは、それを作成したワークロードよりも長く残りがちです。
アプリケーションが削除されたり移行されたりすると、そのPVCは残されたままストレージを消費し、コストを増加させます。
Kubernetes v1.37では、PVCの「最終使用」の追跡がPersistentVolumeClaimUnusedSinceTimeフィーチャーゲートの下でベータに昇格します。
このゲートはアルファ(v1.36)ではデフォルトで無効の状態で提供されていましたが、現在はデフォルトで有効です。
この機能はPersistentVolumeClaimStatusに新しいUnused Conditionを追加し、既存のPVC保護コントローラーがこれを管理します: PVCを参照する最後の非終了状態のPodがなくなるとStatus=True (Reason=NoPodsUsingPVC)となり、Podが再び参照を開始するとすぐにStatus=False (Reason=PodUsingPVC)に戻ります。
このConditionのlastTransitionTimeは「未使用になった時点」のタイムスタンプも兼ねるため、管理者はPVCが実際にどれだけの期間アイドル状態だったかを調べられます。
Kubernetes自身はどのPodが最後に使用したかを追跡せず、削除の判断も一切しません。
それは完全に管理者に委ねられています。
注意すべき点として、このタイムスタンプはコントローラーがPVCを使用するPodがないことを観測した時点を反映しており、インフラストラクチャのレベルでボリュームがアンマウントされた正確な時刻ではありません。
そのため、報告されるアイドル時間は実際の値より少し短くなることはあっても、過大に報告されることはありません。
この取り組みは、SIG Storageが主導したKEP #5541の一環として行われました。
etcdのRangeStreamのサポート
etcdの単項(unary)なRange RPCは、レスポンス全体をメモリ上に構築してから返すため、大規模環境では問題になります。
大きなlist、たとえば大規模クラスターでkube-apiserverのwatchキャッシュがウォームアップする場合、生のキーバリューのスライス、そのシリアライズされたprotobuf形式、そしてgRPCの送信バッファがすべて同時にメモリ上に存在する必要があり、その結果生じるスパイクはkube-apiserverにも波及します。
ページネーションも根本的なコストを解決しません。
分割された各ページであっても、結果の総数を再計算するためにB-treeインデックス全体を走査することで、O(limit)であるべき操作がページごとにO(total_keys)になってしまうためです。
Kubernetes v1.37では、etcdのRangeStreamのサポートがEtcdRangeStreamフィーチャーゲートの下で、直接ベータとして提供されます(kube-apiserverのみ、デフォルトで有効)。
このリリースでは、既存のRangeRequestを再利用しつつ、バッファリングされた1つのblobではなくチャンクを返す、サーバーストリーミング型の新しいRangeStream RPCが追加されます: サーバーは適応的なチャンクサイズで内部的にページネーションし(各チャンクの目標サイズはMaxRequestBytesとそれまでに観測された値のサイズに基づいて調整されます)、マージされたストリームがスナップショットとして一貫した状態を保つよう単一のMVCCリビジョンを固定し、キーの総数は別途インデックスを走査するのではなくストリーミング中に構築する集計から導出します。
主な利用者はkube-apiserverのwatchキャッシュの初期化であり、リスト全体をまずメモリ上に組み立てるのではなく、到着した各チャンクをその場で合成されたcreatedイベントにデコードするようになりました。
WatchListが無効な場合の直接的なGetList呼び出しにも、同じ扱いが適用されます。
この機能にはetcd 3.7以降が必要です。
それより古いetcdに対しては、kube-apiserverがUnimplementedのレスポンスを検出し、動作を変えることなく自動的に単項のRangeにフォールバックします。
固定されたリビジョンがストリームの途中でコンパクションされた場合、kube-apiserverはそれを他のwatchキャッシュの初期化の失敗と同様に扱ってリトライします。
これは、ページネーションされたList呼び出しが現在すでに遭遇しうるコンパクションの競合と比べて悪化するものではありません。
ベータ昇格の基準には、5000ノードのクラスターで大きなlistのレイテンシーを測定するスケーラビリティテストが含まれます。
また、新しいRPCを直接試したい人のためにetcdctl get --streamも併せて提供されます。
この取り組みは、SIG etcdが主導したKEP #5966の一環として行われました。
watchオブジェクトの並行デコード
kube-apiserverはetcdからのすべてのwatchイベントを単一のゴルーチン(goroutine)上で1つずつデコードして変換します。
そのため、イベントごとの変換が1つ遅いだけで、特にCRDの変換Webhookの呼び出しなどでは、その後ろにキューイングされたすべてのイベントがブロックされます。
ビルトインのリソースでは、単なる煩わしさにとどまることが大半ですが、提供されるバージョンが保存されているバージョンと異なるCRDでは、コールドキャッシュを逐次的に変換するのに数分かかることがあります。
これがetcdのデフォルトである5分のコンパクション間隔を超えると、キャッシュが読み取りを開始したリビジョンが初期化の完了前にコンパクションされ、watchを再開できなくなります。
そして十分に大きなリソースでは、初期化がやり直されるだけで収束せず、その間そのリソースをlistまたはwatchしようとするすべてのクライアントはエラーを受け取ります。
ConcurrentWatchObjectDecodeゲートは実はv1.31以降、デフォルトで無効のベータとして存在していましたが、Kubernetes v1.37でデフォルトで有効になります。
有効にすると、デコードと変換のステップは単一のゴルーチンではなく上限のあるワーカーゴルーチンのプール(デフォルトは10。8〜12あたりで効果が横ばいになることを示した測定に基づいて調整されています)で実行され、コレクターが配信前にイベントを元の順序に組み直すため、イベントの順序は厳密に保たれます。
15万Podを超えるベンチマークでは、並行デコード単体でキャッシュの初期化が約40%短縮され、同じリリースで導入される新しいEtcdRangeStream機能と組み合わせると約55%短縮されます(KEP 5966を参照)。
注意すべき主なトレードオフは、変換Webhookの負荷です。
この機能を有効にすると、キャッシュの初期化中に1つずつではなく最大10個の変換がWebhookに対して並行して実行されるようになります。
呼び出しの総量は変わらず、同時に実行される数だけが変わるため、これは主に自身の並行数を10未満に制限しているWebhookで問題になります。
この取り組みは、SIG API Machineryが主導したKEP #6178の一環として行われました。
コントローラーの陳腐化の軽減
kube-controller-managerのすべてのコントローラーは、kube-apiserverを監視して構築されたローカルキャッシュを基に動作しており、そのwatchストリームは結果整合性しか持ちません。
変更はミリ秒で反映されることもあれば、負荷がかかっている状況では数秒、あるいは数分かかることもあります。
現状、管理者はその遅延を把握できず、通常の遅延と危険なほど同期がずれたコントローラーを区別する手段もありません。
そのため、コントローラーはすでに陳腐化した世界の見え方に対して調整を続けてしまう可能性があります。
コントローラーの陳腐化の軽減はv1.36以降ベータであり、StaleControllerConsistency<Controller>フィーチャーゲートの下でコントローラー単位にデフォルトで有効になっています。
Kubernetes v1.37ではこれをHorizontalPodAutoscalerコントローラーにも拡張し、以下で説明するサーキットブレーカー型の変種と追加のメトリクスを導入します。
中核となる仕組みはread your writesの保証です: client-goのResourceEventHandlerFuncsに新しいBookmarkFuncコールバックが追加され、既存のadd/update/deleteのコールバックが取りこぼすエッジケースでも、コントローラーは管理対象のオブジェクトのリソースバージョンを確実に追跡できます。
コントローラーは自身の書き込みのリソースバージョンを記録し、次の調整の際にはinformerのキャッシュがその書き込みに実際に追いつくまでスキップして再キューイングします。
DaemonSetコントローラーはその良い例です。
DaemonSetからPodへのリソースバージョンを追跡することで、自身の陳腐化したPodキャッシュに対して再調整しないようにしています。
2つ目のサーキットブレーカー型の変種は、node-lifecycleのようなレイテンシーに敏感なコントローラーを対象としています。
これらのコントローラーは、そうでなければ陳腐化したノードのリースをキャッシュから読み取り、期限切れだと誤って判断してしまう可能性があります。
この変種では、陳腐化した読み取りに基づいて動作する代わりに、破壊的な判断の際には即時(live)でGETを実行し、追いつくまでキャッシュを「準備ができていない」とマークします。
StaleControllerConsistencyは軽減策そのものを制御します(当初はKCMが大規模とみなしたコントローラーに限定されます)。
MonitorInformerStalenessは観測専用の別のゲートで、informerのキャッシュが実際にどれだけ遅れているかを明らかにするためだけに、5秒ごとにapiserverを直接ポーリングします。
AtomicFIFOとUnlockWhileProcessingFIFOは、この軽減策が依存するclient-goのワークキューの基盤部分です。
これらはいずれもリコンサイラーのデフォルトの動作を変更しません。
一時停止して再キューイングされたコントローラーは、実際には単にキャッシュを待っているだけでも停止しているように見えることがあります。
また、不可逆な処理は何もないため、クリーンにロールバックできます。
この取り組みは、SIG API Machineryが主導したKEP #5647の一環として行われました。
マニフェストベースのAdmission Controlの設定
Kubernetesでは、Admission ControlがAPIサーバーに受け入れられる前のリソースに対してポリシーを適用する役割を担っています。 しかし、Kubernetes APIを通じて設定されたAdmission Webhookとポリシーは、クラスターの起動時にAPIサーバーとetcdに依存しており、Admissionの設定リソース自体を保護できません。 これはクラスターのブートストラップ中に隙を生み、十分な特権的アクセス権を持つユーザーが重要なAdmissionポリシーを変更または削除できてしまいます。
Kubernetes v1.37では、マニフェストベースのAdmission Controlの設定がベータに昇格し、Admission WebhookとCELベースのポリシーをディスク上のマニフェストファイルから読み込み、APIサーバーの起動時から適用できるようになります。 この設定はKubernetes APIとは独立して管理されるため、APIベースのAdmissionリソースを変更から保護することもできます。 マニフェストファイルは変更が監視され、妥当な更新は自動的に再読み込みされます。 一方、妥当でない更新の場合は、以前に読み込まれた設定がそのまま維持されます。
この取り組みは、SIG API Machineryが主導したKEP #5793の一環として行われました。
復号できないリソースの扱いの改善
Kubernetesはリソースをetcdに保存し、そこでは機微なデータを保護するために保存データの暗号化を利用できます。 しかし、たとえば暗号化キーが利用できないなどの理由で暗号化されたリソースを復号できなくなると、APIサーバーはそれらのリソースを通常どおり読み取ったり管理したりできません。 その結果、Kubernetes APIを通じてアクセスできないリソースがクラスターに残り、管理者はそれらを復旧するために背後のetcdのデータを手動で変更する必要が生じます。
Kubernetes v1.37には、クラスターの管理者がAPIサーバーで復号できないリソースを特定して削除するためのベータのサポートが含まれています。
Kubernetes v1.32で導入され、これまでアルファだったこのサポートにより、問題のあるAPIリソースはetcdのファイルを直接操作するのではなくKubernetes APIを通じて削除できます。 この機能は、管理者が削除前に影響を受けるリソースを確認するためのセーフガードも提供します。
この取り組みは、SIG Authが主導したKEP #3926の一環として行われました。
アルファの新機能
StatefulSetのロールアウトにおける新しいRecreate戦略
Kubernetes v1.37では、StatefulSetのロールアウトにRecreate戦略が導入されます。
StatefulSet APIはこれまで、OnDelete(手動)とRollingUpdate(自動、デフォルト)という2つの更新戦略のみを提供していました。
Deploymentと同様に、Recreate更新戦略は、StatefulSetの.spec.templateに加えられた変更を反映する新しいPodを作成する前に、StatefulSetのすべてのPodを削除します。
この戦略を使用するには、StatefulSetRecreateStrategyフィーチャーゲートを有効にする必要があります。
この取り組みは、SIG Appsが主導したKEP #3541の一環として行われました。
DRA: 注目すべきアルファ機能
DRA: Nodeの割り当て可能なリソースの要求
Kubernetes v1.37では、CPU、メモリ、Huge PageといったNodeのリソースをDRAを通じて管理するためのアルファのサポートが改善されます。 標準のリソース計上とDRAのリソース計上が統合され、同じNodeの容量が二重に計上されることを防ぎやすくなります。
この更新では、mapping(CPU/メモリのDRAドライバーのように、コアリソースを直接モデル化するデバイス向け)とoverhead(アクセラレーターデバイスのための補助的なホストメモリなど)という個別のAPIフィールドが導入されます。
kubeletはこれらの割り当てをPodおよびコンテナのcgroupに適用し、Memory QoS、OOMスコアの計算、インプレースPodリサイズと統合します。
この取り組みは、SIG Nodeの参加を得てSIG Schedulingが主導したKEP #5517の一環として行われました。
DRA: 導出属性
Kubernetes v1.37では、DRAにおける導出属性のアルファのサポートが導入されます。 ワークロードはCEL式を使ってデバイスの情報から仮想的な属性を作成し、関連するデバイスを選択する際にそれを利用できます。
これにより、ドライバーが異なる属性名や形式を使っている場合でも、GPUやネットワークインターフェースなどのデバイスを同じ場所に配置しやすくなります。 たとえばワークロードは、共有のNUMA識別子を導出し、それを使ってトポロジーが一致するデバイスを選択できます。
この取り組みは、SIG Networkの参加を得てSIG Schedulingが主導したKEP #6080の一環として行われました。
DRA: デバイス互換性グループ
DRAは、異なるパーティショニングや仮想化の方式をサポートするデバイスの管理に利用できます。 しかし、GPUにおけるMIGとvGPUのように、これらの構成の一部は同じ物理デバイス上で同時に利用できません。 これまでは、こうした非互換性はスケジューラーがすでに判断を下した後、デバイスの準備中にしか検出できませんでした。
Kubernetes v1.37では、DRAにデバイス互換性グループが追加され、リソースドライバーがどのデバイスを一緒に割り当てられるかを記述できるようになります。 スケジューラーは割り当てを判断する際にこの情報を利用でき、不完全なデバイスが一緒に割り当てられることを防ぎ、不完全なデバイス構成によるPodの起動失敗を回避します。
この取り組みは、SIG Schedulingが主導したKEP #5963の一環として行われました。
インプレースPodリサイズのためのスケジューラーのプリエンプション
Kubernetes v1.37では、(オプトイン、アルファの)InPlacePodVerticalScalingSchedulerPreemptionフィーチャーゲートの下で、インプレースPodリサイズのためのスケジューラーのプリエンプションが導入されます。
この変更は、中核となるインプレースPodの垂直スケーリング機能がGAに昇格した後も残っていた、重要な機能上の欠落に対処するものです。
これまでは、実行中のPodがNodeの利用可能な容量を超える追加のリソースを要求した場合、kubeletはその要求をDeferredとマークし、Node上で十分なリソースが利用可能になるまでPodは待機したままでした。
この機能強化により、Kubernetesのコントロールプレーンは使用率が上限に達したNode上の容量を能動的に解放し、優先度の低いワークロードをプリエンプションできるようになるため、重要度が高く優先度の高いアプリケーションの保留中のインプレースリサイズを成功させられます。
この取り組みは、SIG Schedulingが主導したKEP #5836の一環として行われました。
メモリベースのボリュームの動的なリサイズ
これもインプレースPodの垂直スケーリングを基盤とする機能で、アルファのメモリベースのボリュームのインプレーススケーリングはPodの/resizeサブリソースを拡張します。
このサブリソースはこれまで、コンテナを再起動せずにCPUとメモリを動的に調整することしかできませんでしたが、実行中のPod上でメモリベース(medium: Memory)のemptyDirボリュームのsizeLimitを更新できるようになります。
ボリュームのsizeLimitが/resizeサブリソースを通じて明示的に調整されると、kubeletはコンテナを中断させることなく基盤となるtmpfsのマウントを動的に更新し、同時にメモリ不足エラーや退避(eviction)の誤検知を安全に防ぎます。
これは、メモリ上のエフェメラルストレージに依存するステートフルなワークロードやメモリを大量に使うワークロードで特に有用であり、Podの再起動やアプリケーションのダウンタイムを発生させることなく、コンテナのメモリ容量と合わせてストレージの上限を動的にスケールできます。
これはオプトインの、デフォルトで無効なアルファ機能です。
試すには、InPlacePodVerticalScalingMemoryBackedVolumesフィーチャーゲートを有効にしてください。
この取り組みは、SIG NodeとSIG Storageが主導したKEP #6030の一環として行われました。
Node向けの特化したライフサイクル管理
Kubernetesのいくつかのコンポーネントは、Nodeのライフサイクルの状態を把握する必要がありますが、現状ではそれぞれがNodeのReady状態、Taint、Podの状態、ラベル、アノテーション、プロバイダーのAPIといった異なる組み合わせからそれを推測しています。
この機能強化では、Nodeに標準化されたライフサイクルのConditionが導入され、管理者はコアのコントローラーやエコシステムのツールが利用できるライフサイクルの状態を、Kubernetesが管理する単一の場所で公開できるようになります。
新しく追加されるNodeのConditionは、DrainInProgress、Drained、MaintenancePlanned、MaintenanceInProgress、GracefulNodeShutdownInProgressです。
この取り組みは、SIG Nodeが主導したKEP #5683の一環として行われました。
WAS: 注目すべきアルファ機能
CompositePodGroup API
これまでのリリースでは、フラットな構造を持つワークロードのGangスケジューリングのサポートが導入されましたが、現代のAI/MLワークロードは複雑で、より高度なスケジューリングの要件を持ちます。
Kubernetes v1.37では、新しいアルファのCompositePodGroup APIにより、Kubernetesは複雑なワークロードをPodのフラットな集合ではなくグループの階層構造として記述できるようになります。
これにより、多階層のGangスケジューリング、ワークロードを考慮したプリエンプション、トポロジーを考慮したスケジューリングが可能になります。
この取り組みは、SIG Schedulingが主導したKEP #6012の一環として行われました。
Workload Aware SchedulingのコントローラーAPI
Kubernetes v1.37では、ワークロードのコントローラー(JobSet、TrainJob、LWS、RayJobなど、およびJobのようなコアのワークロード)をWorkload-aware Scheduling(WAS)と統合するための共通のフレームワークが、アルファ機能として提供されます。
このフレームワークは、トポロジー制約やDisruptionポリシーといった再利用可能なscheduling.k8s.ioのAPIプリミティブと、スケジューリングリソースの作成を扱う共有ライブラリを提供します。
これにより、コントローラーは同じスケジューリングのロジックを個別に実装することなく、自身のAPI内でWASの機能を一貫した方法でネイティブに公開できます。
この取り組みは、SIG Schedulingが主導したKEP #6089の一環として行われました。
ワークロードAPIとJobコントローラーの統合
Kubernetes v1.36で限定的な機能として最初に導入されたこの機能は、Workload Aware SchedulingのコントローラーAPIを基盤とし、Kubernetes v1.37でbatch/v1のJobにユーザー向けの新しいspec.schedulingフィールドを追加します。
これによりユーザーは、スケジューリングポリシー、トポロジー制約、Disruptionモード、リソースクレームを明示的に設定できます。
spec.schedulingが省略された場合、JobはデフォルトでBasicスケジューリングとなり、既存の動作を維持しつつ、minCountによるゲートを強制することなくワークロードを考慮したスケジューリングのためのBasicなWorkload/PodGroupを作成します。
ユーザーはGangスケジューリングを明示的にオプトインすることもできます。
その場合minCountはデフォルトでJobのparallelismとなり、コントローラーは独自の変換ロジックを実装するのではなく共有のworkloadbuilderライブラリを使って、スケジューリングの設定を対応するWorkloadおよびPodGroupのオブジェクトに変換します。
この取り組みは、SIG Schedulingが主導したKEP #5547の一環として行われました。
nftables向けのlocalhost NodePortユーザースペースプロキシ
Kubernetes v1.37では、nftablesのkube-proxyバックエンドにオプトインのユーザースペースプロキシが追加され、NodePortのServiceにIPv4とIPv6のlocalhost経由でアクセスできるようになります。
これにより、これまでnftablesがlocalhostのNodePortを提供できなかったnftablesとiptablesのバックエンド間の差が解消されます。
このプロキシは、kube-proxyの--nodeport-addressesの設定にlocalhostまたはループバックアドレスが含まれている場合に有効になります。
これは、localhost:<NodePort>への接続に依存するローカルのコンテナレジストリなどのワークロードで役立ちます。
iptablesおよびipvsバックエンドの既存の動作は変わりません。
この取り組みは、SIG Networkが主導したKEP #6032の一環として行われました。
その他の注目すべき変更点
StatefulSetのmaxUnavailableがデフォルトで再び有効に
v1.36でバグが確認されたことを受けて無効化されていたStatefulSetのmaxUnavailableフィールドは、Kubernetes v1.37でデフォルトで再び有効になりました。
このバグは、不正なStatefulSetの初期リビジョンがReadyにならないPodを作成し、MaxUnavailableStatefulSetが有効な場合にStatefulSetのコントローラーがそのPodを修正済みの新しいリビジョンに更新できないという状況で発生していました。
このバグが発生すると、影響を受けたPodは無期限にCrashLoopBackOffの状態でスタックする可能性がありました(kubernetes#137409を参照)。
nftablesのパフォーマンスの改善
kube-proxyはnftablesのルール操作に、nftコマンドラインツールを介さずカーネルのnetlinkインターフェースを使用するようになりました。
これによりkube-proxyはnftablesのルールをより効率的に検査し、管理できるようになるため、ルール管理のパフォーマンスが向上します。
client-goにおけるコンテキストの扱いとコンテキストロギング
client-goにおけるコンテキストの伝播とコンテキストロギングのサポートが完了しました。 ただし、基盤となるAPIがコンテキストの受け渡しをサポートしていないため、グローバルなklogのロガーに依然として依存している少数の認証プラグインのログ呼び出しは例外です。
v1.37での昇格、非推奨、削除
GAへの昇格
これはGA(一般提供)に昇格したすべての機能を一覧にしたものです。 アルファからベータへの昇格や新機能を含む更新の完全なリストについては、リリースノートをご覧ください。
このリリースには、GAに昇格した合計16個の機能強化が含まれています:
- 再帰的なSELinuxラベル変更の高速化
- ClusterTrustBundle
- Pod証明書
- Podのホスト名として任意のFQDNの設定を許可
- DRA: 標準化されたネットワークインターフェース情報を扱えるResourceClaimのstatus
- HorizontalPodAutoscalerの設定可能な許容値
- Serviceの名前に対する緩和されたバリデーション
- Device PluginとDRAに対するPodのstatusへのリソース健全性ステータスの追加
- DRA: デバイスのTaintとToleration
- DRA: DRAドライバー経由での拡張リソース要求の処理
- Nodeが宣言する機能
- サンドボックスの作成に関するConditionの追加
- ストレージバージョンマイグレーターのin-treeへの移行
- 回復力のあるwatchキャッシュの初期化
- DRA: 標準のnumaNodeデバイス属性
- metrics.k8s.io APIの定義
- KYAML
非推奨、削除、コミュニティの更新
Kubernetesの開発と成熟に伴い、プロジェクト全体の健全性を向上させるために、機能が非推奨になったり、削除されたり、より良いものに置き換えられたりすることがあります。 このプロセスの詳細については、Kubernetesの非推奨と削除のポリシーをご覧ください。 これらの非推奨と削除の多くは、非推奨と削除に関するブログで告知されました。
kube-dnsの非推奨化
CoreDNSはKubernetes v1.13以降デフォルトのクラスターDNSアドオンであり、kube-dnsはそれ以降の進化に追いついていません。
EndpointSliceやデュアルスタックのServiceといった機能はkube-dnsでは利用できません。
Kubernetesはすでにkube-dnsサブプロジェクトを終了し、node-local-dnsを独立したリポジトリに分離しました。 node-local-dnsはそこで引き続きメンテナンスされており、CoreDNSと連携して動作します。 v1.40以降、kube-dns向けの新しいパッケージがビルドされることはない見込みです。
まだkube-dnsを運用している場合は、クラスターをCoreDNSへ移行する計画を立て始めてください。
kube-proxyのipvsモードのサポートの非推奨化
kube-proxyのipvsモードのサポートは、iptablesのパフォーマンスのボトルネックを解決するためにv1.8で導入されました。
しかし、カーネルのipvs APIだけではKubernetesのServiceを完全に実装できないため、ipvsモードは内部で引き続きiptablesを使用しています(KEP-3866「The ipvs mode of kube-proxy will not save us」)。
ipvsモード(またはKubeProxyConfigurationのmode: ipvs)でkube-proxyを実行しているクラスターは、起動時に非推奨の警告をログに出力するようになりました。
非推奨化のタイムラインは次のとおりです:
- v1.40までに、
kube-proxyのipvsモードはデフォルトで無効化される見込みです(フィーチャーゲートによる選択は引き続き可能) - v1.43までに、
ipvsモードのサポートは完全に削除される予定です(KEP #5495、昇格基準)。
現在どのモードで実行しているかを確認するには、次のコマンドを使用してください:
kubectl -n kube-system get configmap kube-proxy -o jsonpath='{.data.config\.conf}' | grep 'mode:'
この非推奨化の背景にある理由については、KEP #5495をご覧ください。
kubectl: kubectl run --filename/-fの非推奨化
kubectl runが生成するPodは常にNAMEや--imageといったCLIの引数のみから構築されるため、kubectl runの--filename(または-f)フラグは非推奨になります。
元のIssueと議論については、kubernetes/kubernetes#138671をご覧ください。
kubelet: Static PodがSecretやConfigMapを参照できなくなりました
Static PodはAPIサーバーを経由して作成されないため、APIリソースを直接読み取ることは元々想定されていませんでしたが、バグによりconfigMapRefやsecretRefといったフィールドを通じてSecretやConfigMapを参照できていました。
このバグは修正され、v1.37以降これらの参照は厳密に禁止されます。
また、これまでこの制限をオプトアウトできていたPreventStaticPodAPIReferencesフィーチャーゲートは削除されました。
元のIssueと議論については、kubernetes/kubernetes#140226をご覧ください。
進行中の大きな変更: cgroup v1のサポートの将来的な削除
最新のLinuxディストリビューションとコンテナランタイムがcgroup v2をデフォルトで使用していることから、レガシーなcgroup v1のサポートは公式に段階的に終了しつつあります。
v1.35のリリース以降、failCgroupV1の設定はデフォルトでtrueになっています。
そのため、明示的な設定のオーバーライドを適用しない限り、cgroup v1に依存しているNodeではkubeletの初期化が失敗します。
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
failCgroupV1: false # 一時的なオーバーライド
このオーバーライドの使用は短期的な対処と考えるべきです。 Memory QoSやメモリベースのボリュームのインプレースなスケーリングといった高度なリソース管理機能は、cgroup v2でのみ動作します。 このオーバーライドはKubernetes v1.37でも引き続き利用できますが、cgroup v1のサポートは将来のリリースで削除される予定のため、cgroup v2への移行を推奨します。
この非推奨化の詳細については、KEP #5573をご覧ください。
リリースノート
Kubernetes v1.37リリースの詳細については、リリースノートをご覧ください。
入手方法
Kubernetes v1.37はKubernetes公式サイトのダウンロードページまたはGitHubから直接ダウンロードできます。
Kubernetesを始めるには、チュートリアルをチェックするか、minikubeを使用してローカルKubernetesクラスターを実行してください。 また、kubeadmを使用して簡単にv1.37をインストールすることもできます。
リリースチーム
Kubernetesは、コミュニティの支援、コミットメント、献身的な努力なくしては成り立ちません。 各リリースチームは、皆さんが利用するKubernetesリリースを構成する様々な要素を協力して構築する、献身的なコミュニティボランティアで構成されています。
これを実現するには、コードそのものからドキュメント作成、プロジェクト管理に至るまで、コミュニティのあらゆる分野の専門スキルが必要です。
Kubernetes v1.37リリースをコミュニティに届けるために多くの時間を費やして取り組んでくれたリリースチーム全体に感謝します。
リリースチームには、初参加のShadow(見習い)から、複数のリリースサイクルで経験を積んだベテランのチームリードまで、様々なメンバーが参加しています。
リリースリードのDipesh Rawatに心より感謝します。 成功したリリースサイクルを通じて私たちを支え、私たちのために声を上げ、全員が最善の形で貢献できるよう配慮し、そしてリリースプロセスの改善に挑戦させてくれました。
プロジェクトの活動状況
CNCF K8sのDevStatsプロジェクトは、Kubernetesおよび様々なサブプロジェクトの活動状況に関する興味深いデータポイントを集計しています。
これには個人の貢献から貢献企業数まで含まれ、このエコシステムの発展に費やされる取り組みの深さと広さを示しています。
v1.37リリースサイクル(2026年5月18日から2026年8月26日までの15週間)において、Kubernetesには最大212の異なる企業と1,754人の個人から貢献がありました。
データソース:
なお、「貢献」とはコミットの作成、コードレビュー、コメント、IssueやPRの作成、PRのレビュー(ブログやドキュメントを含む)、またはIssueやPRにコメントすることを指します。
貢献に興味がある場合は、はじめにのページをご覧ください。
イベント情報
世界各地で開催される今後のKubeConをご覧ください:
- KubeCon + CloudNativeCon China: 2026年9月7日-9日 | 中国、上海
- KubeCon + CloudNativeCon North America: 2026年11月9日-12日 | アメリカ、ソルトレイクシティ
2026年の残りの期間に開催される今後のKubernetes Community Days(KCDs)をご覧ください:
2026年9月
- KCD x Ceph x OpenInfra Day Korea: 2026年9月1日 | 韓国、ソウル
- KCD San Francisco Bay Area: 2026年9月1日 | アメリカ、マウンテンビュー
- KCD Washington DC: 2026年9月15日 | アメリカ、ワシントンD.C.
- KCD Gujarat: 2026年9月19日 | インド、アーメダバード
- KCD São Paulo: 2026年9月26日 | ブラジル、サンパウロ
- KCD Sofia: 2026年9月29日 | ブルガリア、ソフィア
2026年10月
- KCD UK – Edinburgh: 2026年10月19日-20日 | イギリス、エディンバラ
- KCD Nigeria: 2026年10月24日 | ナイジェリア、ラゴス
2026年11月
- KCD Porto: 2026年11月19日-20日 | ポルトガル、ポルト
- KCD Hangzhou: 2026年11月28日 | 中国、杭州
2026年12月
- KCD Suisse Romande: 2026年12月9日-10日 | スイス、メイラン
- KCD Provence: 2026年12月10日 | フランス、エクス=アン=プロヴァンス
- KCD Florida – Miami: 2026年12月11日 | アメリカ、マイアミ
最新のイベント情報はCNCFのイベントページでご確認いただけます。
ウェビナーのご案内
Kubernetes v1.37リリースチームのメンバーと一緒に 2026年9月23日(水)午後4時(UTC) から、このリリースのハイライトについて学びましょう。 詳細および参加登録は、CNCFオンラインプログラム・サイトのイベントページをご覧ください。
参加方法
Kubernetesに関わる最も簡単な方法は、あなたの興味に合った数多くのSpecial Interest Groups(SIGs)のいずれかに参加することです。
どこから始めればよいかわからない場合は、毎月開催されているNew Contributor Orientationsに参加してください。 プロジェクトがどのように構成されているかをコミュニティに向けて解説し、プロジェクトへの最初の貢献の進め方をご案内します。
- Kubernetesのコントリビューターになる方法はコントリビューターガイドをご覧ください
- Kubernetesの最新の動向についてはブログをご覧ください
- Slackに参加してください
- 最新情報はBlueskyでフォローしてください
- LinkedInでフォローしてください
- X(旧Twitter)でフォローしてください
- Discussでコミュニティディスカッションに参加してください
- Stack Overflowで質問を投稿(または質問に回答)してください
- あなたのKubernetesエンドユーザーストーリーを共有してください
- リリースチームについての詳細はKubernetes Release Teamをご覧ください